<?xml version="1.0" encoding="utf-8"?><feed xmlns="http://www.w3.org/2005/Atom" ><generator uri="https://jekyllrb.com/" version="3.10.0">Jekyll</generator><link href="https://lucasoshiro.github.io/feed.xml" rel="self" type="application/atom+xml" /><link href="https://lucasoshiro.github.io/" rel="alternate" type="text/html" /><updated>2026-04-21T19:01:28+00:00</updated><id>https://lucasoshiro.github.io/feed.xml</id><title type="html">Lucas Seiki Oshiro</title><subtitle>Site pessoal</subtitle><author><name>Lucas Seiki Oshiro</name></author><entry xml:lang="pt_br"><title type="html">Usando a primeira e a última versão do Git do Torvalds</title><link href="https://lucasoshiro.github.io/posts/2025-12-12-using-torvalds-git/" rel="alternate" type="text/html" title="Usando a primeira e a última versão do Git do Torvalds" /><published>2025-12-12T00:00:00+00:00</published><updated>2025-12-12T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/using-torvalds-git</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2025-12-12-using-torvalds-git/"><![CDATA[<h2 id="introdução">Introdução</h2>
<p>Talvez uma das histórias mais conhecidas do mundo Open Source é o nascimento do
Git: Linus Torvalds precisava de um sistema de controle de versão para o kernel
Linux e nos deu o Git. Enquanto até hoje ele é o mantenedor do kernel, ele foi
o mantenedor do Git por apenas três meses, de abril a julho de 2005. Desde
então, o Git é mantido por Junio Hamano.</p>

<p>Mesmo após 20 anos desde a troca de liderança, o Git ainda é lembrado como a
segunda obra-prima de Linus Torvalds. Pessoalmente, acredito que o que torna o
Git excelente é seu elegante núcleo que existe desde sua primeira versão que
seja o principal presente que Linus nos deu.</p>

<p>Porém, o quão usável era o Git quando o Torvalds ainda era o mantenedor? Veremos
isso aqui, olhando para duas versões do Git:</p>

<ol>
  <li>O primeiro commit</li>
  <li>A última release feita pelo Torvalds</li>
</ol>

<p>Então, vamos ver o que aconteceu nesse momento da história do Git.</p>

<h2 id="setup">Setup</h2>

<p>Voltemos no tempo. Minha máquina do tempo é o Ubuntu
7.10 Gutsy Gibbon, lançado in 2007. Ele é velho o suficiente para ter pacotes 
nas versões que o Git antigo precisa e, por sorte, encontrei uma
<a href="https://hub.docker.com/r/icomputer7/ancient-ubuntu-docker/">imagem Docker</a>
para isso. Eu realmente queria usá-lo no meu Linux moderno, porém, não é tão
fácil compilá-lo por conta dessas incompatibilidades de bibliotecas.</p>

<p>É bem fácil obter o código-fonte das versões antigas do Git. Ele é, obviamente,
versionado com Git e suas primeiras versões ficarão guardadas para sempre em
seu histórico:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git clone git@github.com:git/git.git
<span class="nb">cd </span>git

<span class="c"># Listando os commits do mais velho para o mais novo. Queremos o primeiro</span>
git log <span class="nt">--reverse</span>

<span class="c"># Listando as versões anteriores à 1.0. Queremos a última lançada por Torvalds</span>
git tag <span class="nt">--list</span> <span class="s1">'v0.*'</span>
</code></pre></div></div>

<p>Tentaremos usar o Git antigo para versionar um simples fizzbuzz em C:</p>

<ol>
  <li>Primeiro commit: um código C simples apenas com <code class="language-plaintext highlighter-rouge">#include &lt;stdio.h&gt;</code> e a
função <code class="language-plaintext highlighter-rouge">main</code></li>
  <li>Segundo commit: o laço com o print</li>
  <li>Terceiro e quarto commit: commits paralelos, um adicionando fizz e o outro buzz</li>
  <li>Quinto commit: merge de fizz e buzz:</li>
</ol>

<p>Este é o grafo de commits que queremos:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>*   merge
|\
| * buzz
* | fizz
|/
* for
* initial
</code></pre></div></div>

<p>Este é o código do fizzbuzz, escrito de uma forma que evita conflitos de merge:</p>

<div class="language-c highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="cp">#include</span> <span class="cpf">&lt;stdio.h&gt;</span><span class="cp">
</span>
<span class="kt">void</span> <span class="nf">print</span><span class="p">(</span><span class="kt">int</span> <span class="n">i</span><span class="p">)</span> <span class="p">{</span>
    <span class="kt">int</span> <span class="n">fizzbuzz</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span>

    <span class="c1">// números fizz</span>

    <span class="k">if</span> <span class="p">(</span><span class="n">i</span> <span class="o">%</span> <span class="mi">3</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="p">{</span>
        <span class="n">printf</span><span class="p">(</span><span class="s">"fizz"</span><span class="p">);</span>
        <span class="n">fizzbuzz</span> <span class="o">=</span> <span class="mi">1</span><span class="p">;</span>
    <span class="p">}</span>

    <span class="c1">// números buzz</span>

    <span class="k">if</span> <span class="p">(</span><span class="n">i</span> <span class="o">%</span> <span class="mi">5</span> <span class="o">==</span> <span class="mi">0</span><span class="p">)</span> <span class="p">{</span>
        <span class="n">printf</span><span class="p">(</span><span class="s">"buzz"</span><span class="p">);</span>
        <span class="n">fizzbuzz</span> <span class="o">=</span> <span class="mi">1</span><span class="p">;</span>
    <span class="p">}</span>

    <span class="c1">// outros números</span>

    <span class="k">if</span> <span class="p">(</span><span class="o">!</span><span class="n">fizzbuzz</span><span class="p">)</span>
        <span class="n">printf</span><span class="p">(</span><span class="s">"%d"</span><span class="p">,</span> <span class="n">i</span><span class="p">);</span>
    
    <span class="n">putchar</span><span class="p">(</span><span class="sc">'\n'</span><span class="p">);</span>
<span class="p">}</span>

<span class="kt">int</span> <span class="nf">main</span><span class="p">()</span> <span class="p">{</span>
    <span class="kt">int</span> <span class="n">i</span><span class="p">;</span>
    
    <span class="k">for</span> <span class="p">(</span><span class="n">i</span> <span class="o">=</span> <span class="mi">0</span><span class="p">;</span> <span class="n">i</span> <span class="o">&lt;</span> <span class="mi">100</span><span class="p">;</span> <span class="n">i</span><span class="o">++</span><span class="p">)</span>
        <span class="n">print</span><span class="p">(</span><span class="n">i</span><span class="p">);</span>

    <span class="k">return</span> <span class="mi">0</span><span class="p">;</span>
<span class="p">}</span>
</code></pre></div></div>

<h2 id="primeira-versão-o-gerenciador-de-informações-do-inferno">Primeira versão: “o gerenciador de informações do inferno”</h2>

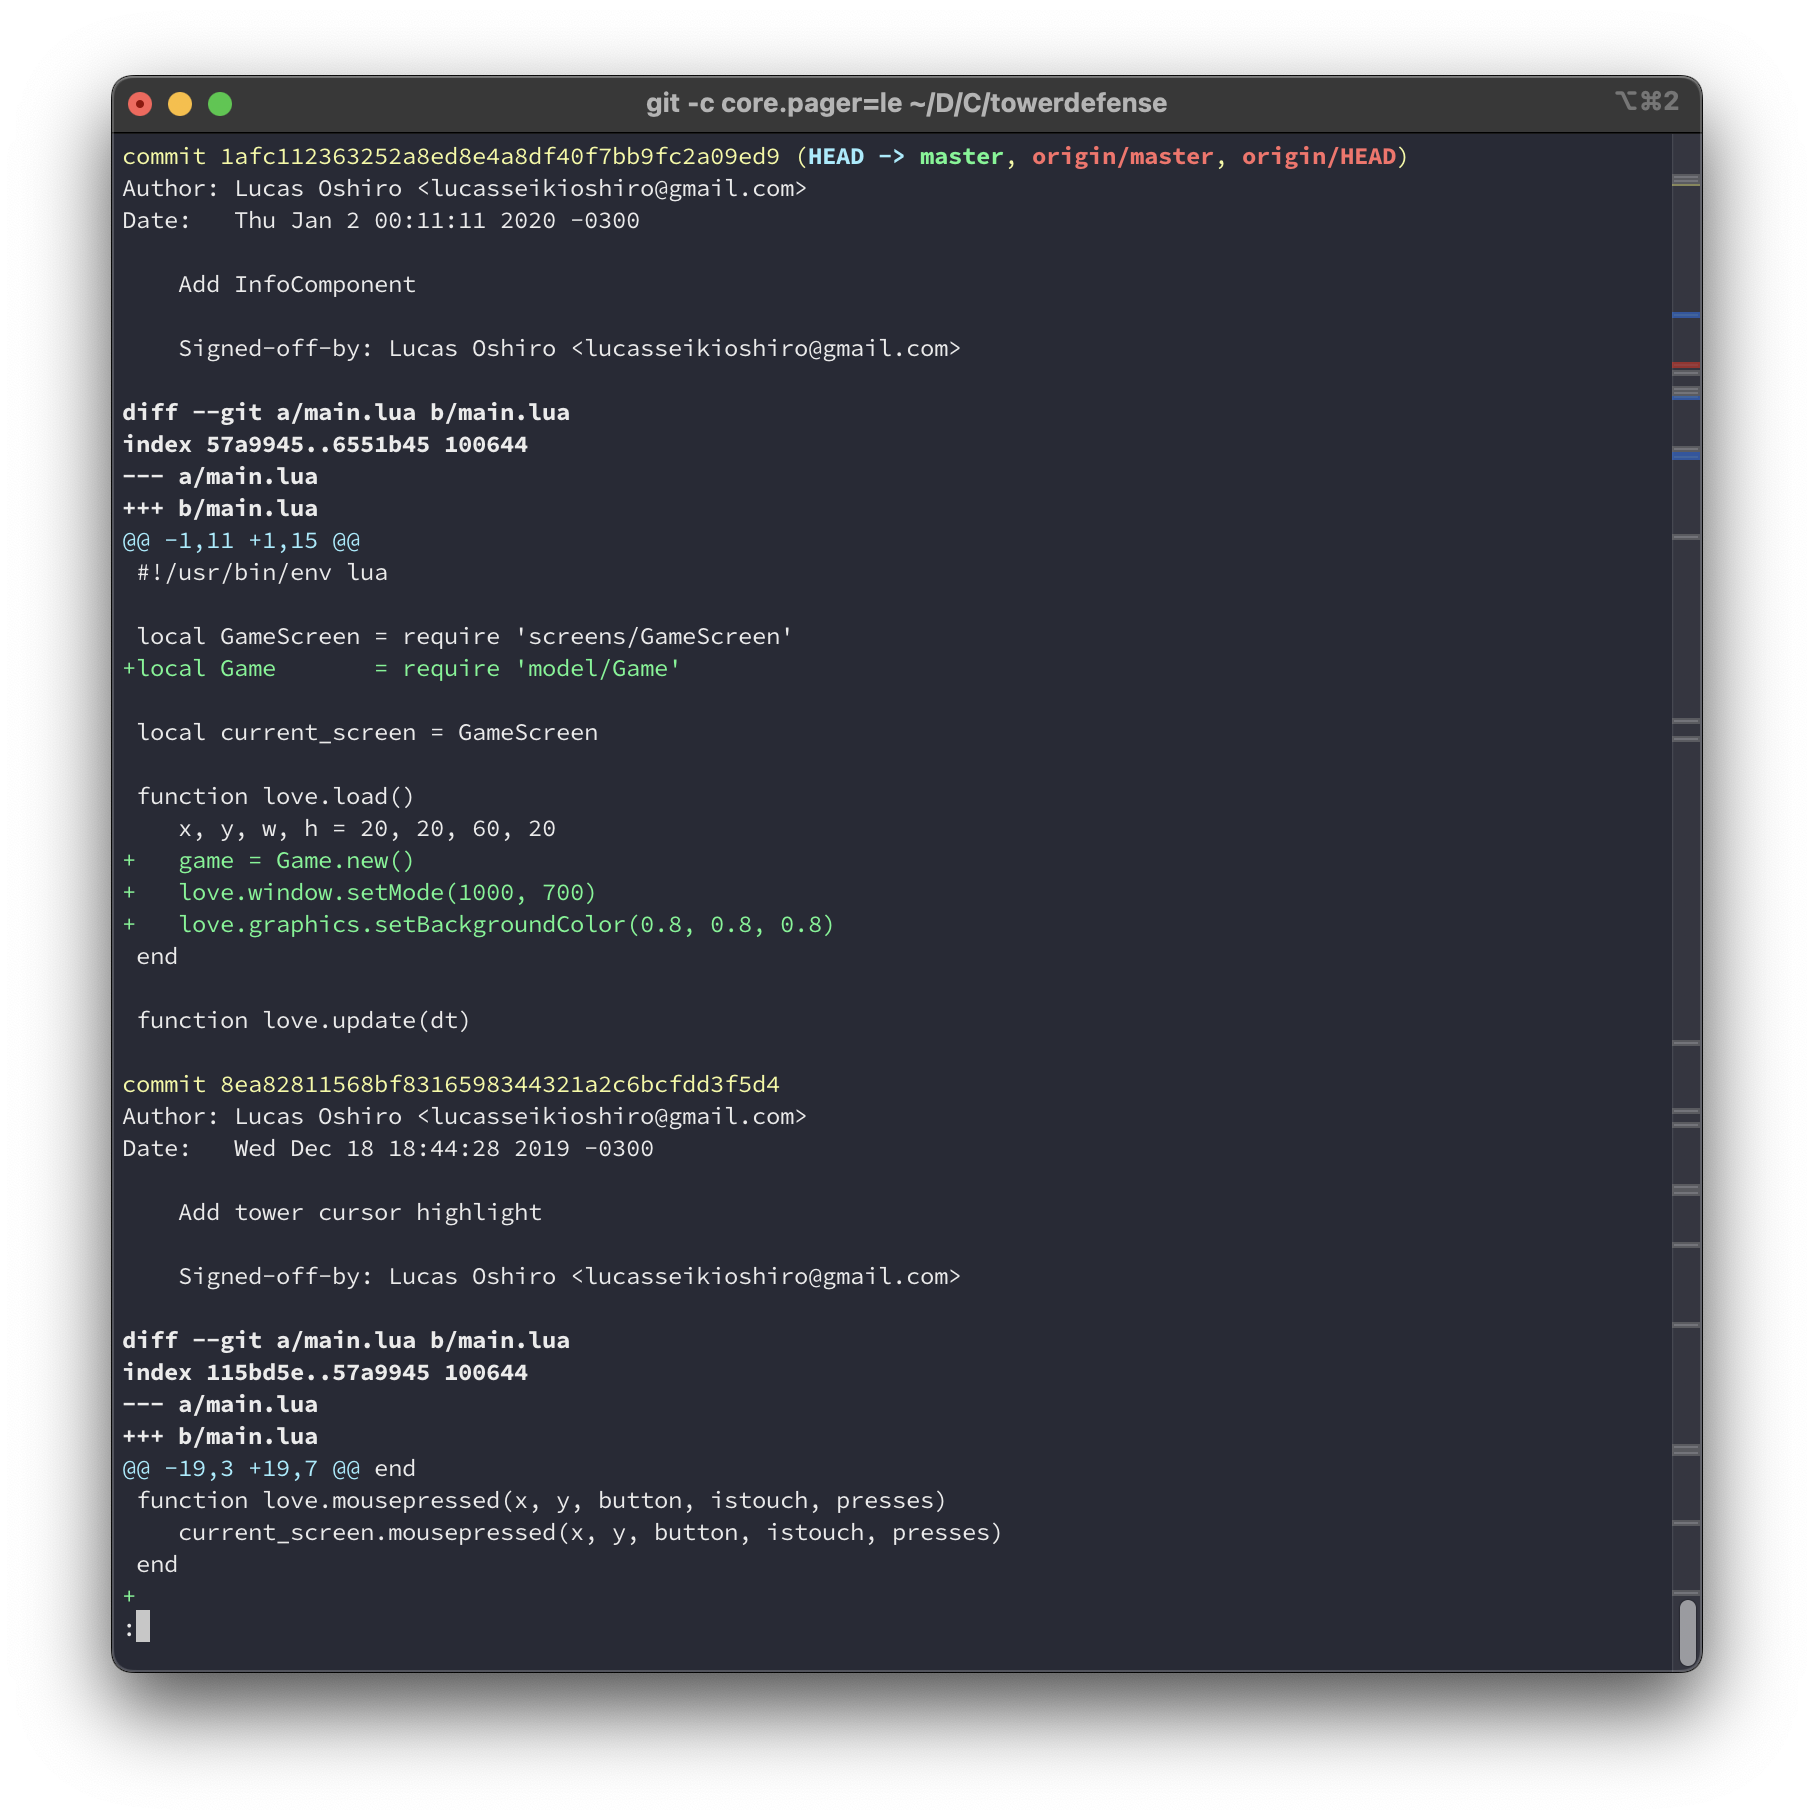
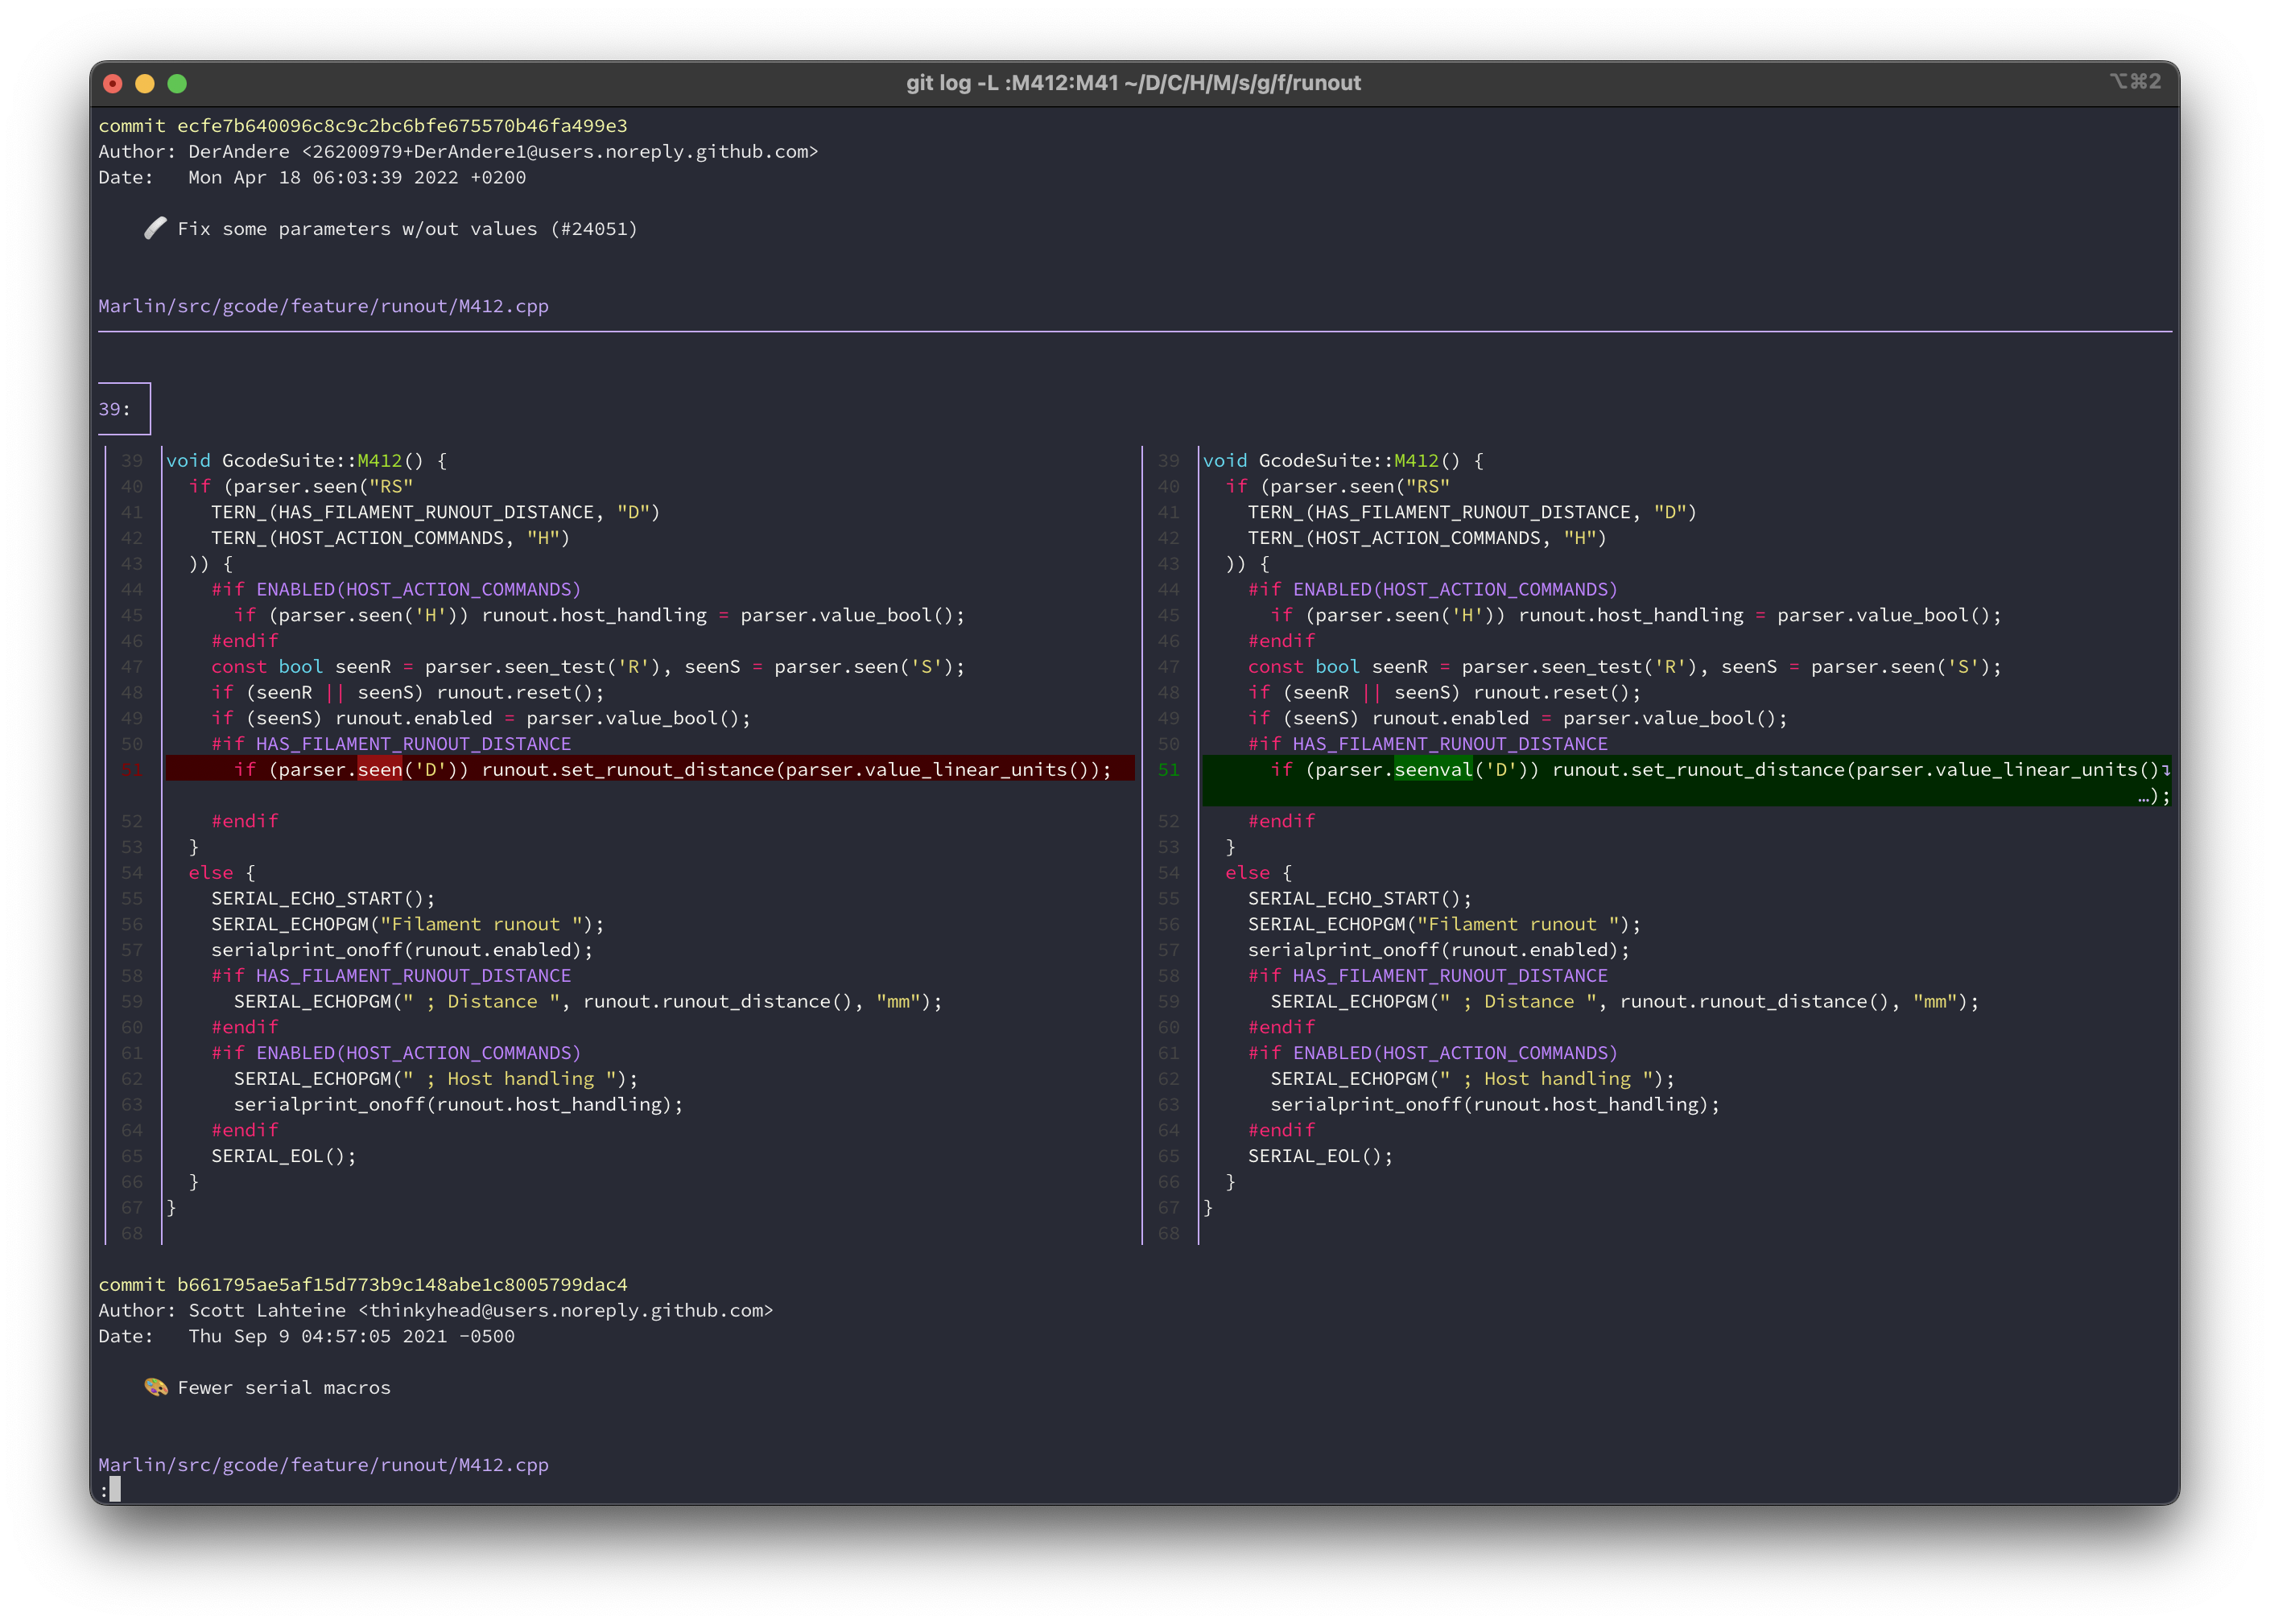
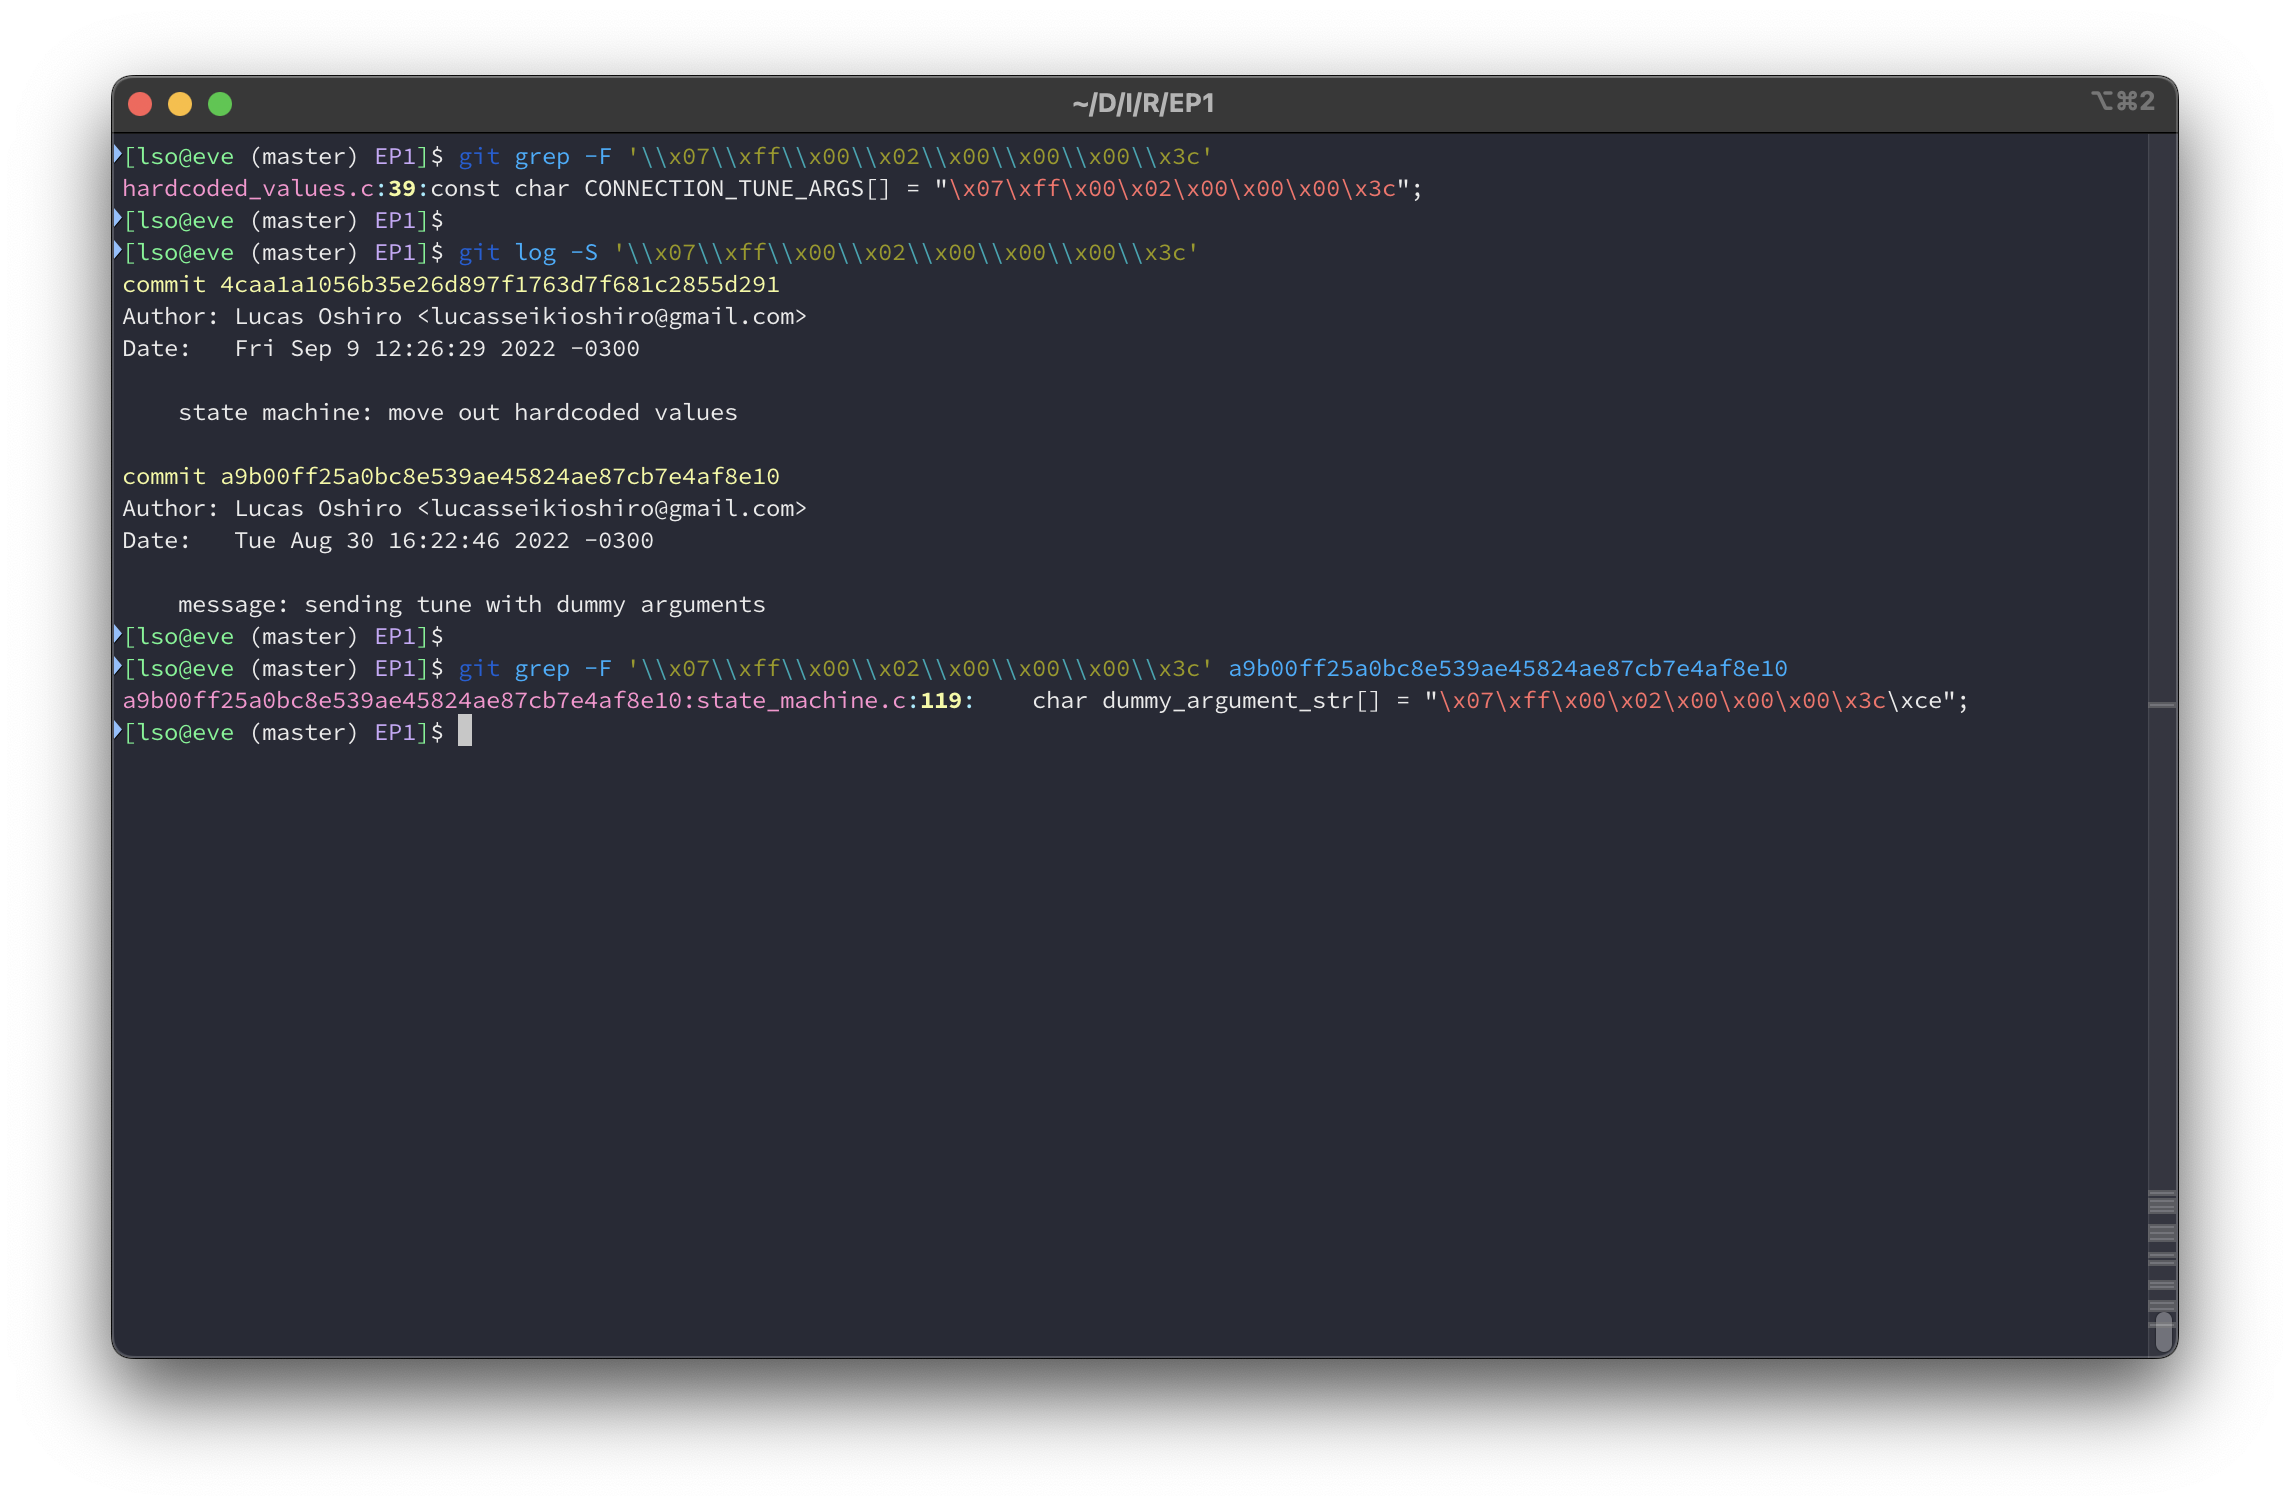
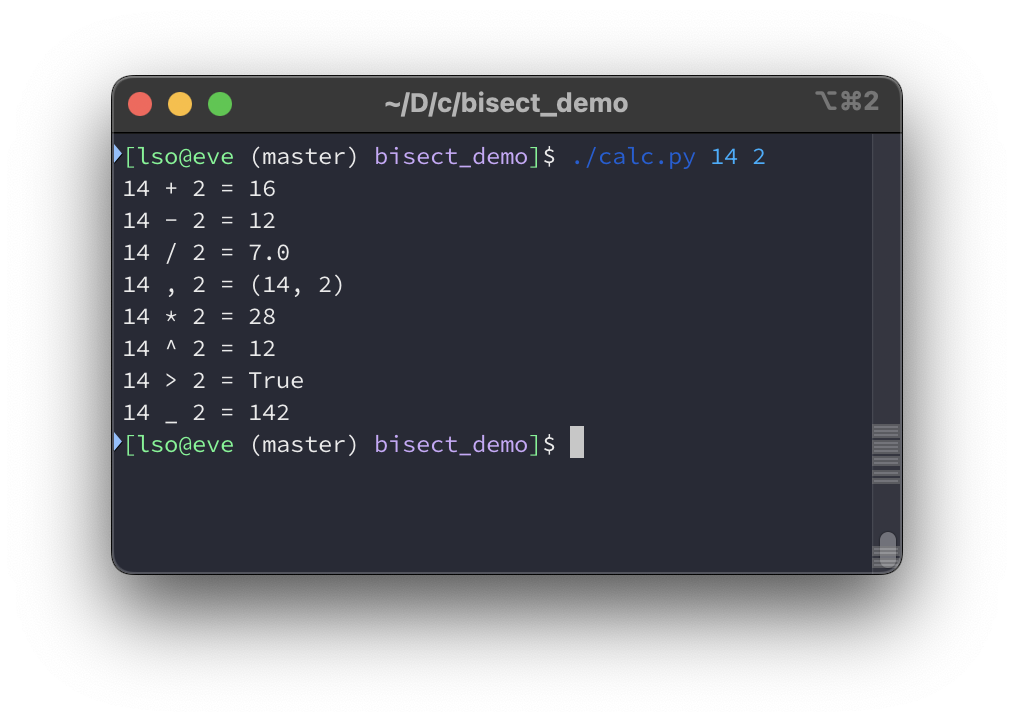
<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/from_hell.png" alt="" /></p>

<p>Voltemos ao primeiro commit do Git, <code class="language-plaintext highlighter-rouge">e83c5163</code>. Só 9 arquivos, um Makefile e um
README. Apenas 1036 linhas de código C. Havia alguns pequenos problemas no
código e não foi possível compilar apenas com <code class="language-plaintext highlighter-rouge">make</code>. Felizmente, os problemas
eram fáceis de corrigir (
<a href="https://github.com/lucasoshiro/git/tree/first-commit">aqui está o código corrigido</a>
).</p>

<p>Primeira coisa estranha que notei é que ele não cria um executável chamado
<code class="language-plaintext highlighter-rouge">git</code>. Em vez disso, ele cria 7 executáveis:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">init-db</code>: equivalente a <code class="language-plaintext highlighter-rouge">git init</code></li>
  <li><code class="language-plaintext highlighter-rouge">update-cache</code>: equivalente a <code class="language-plaintext highlighter-rouge">git update-index</code> ou <code class="language-plaintext highlighter-rouge">git-add</code></li>
  <li><code class="language-plaintext highlighter-rouge">show-diff</code>: mais ou menos parecido com um <code class="language-plaintext highlighter-rouge">git diff</code> no diretório de trabalho</li>
  <li><code class="language-plaintext highlighter-rouge">cat-file</code>: equivalente a <code class="language-plaintext highlighter-rouge">git cat-file -t</code> + <code class="language-plaintext highlighter-rouge">git cat-file -p</code>,
redirecionando a saída para um arquivo temporário</li>
  <li><code class="language-plaintext highlighter-rouge">commit-tree</code>: equivalente a <code class="language-plaintext highlighter-rouge">git commit-tree</code></li>
  <li><code class="language-plaintext highlighter-rouge">read-tree</code>: equivalente <code class="language-plaintext highlighter-rouge">git read-tree</code></li>
  <li><code class="language-plaintext highlighter-rouge">write-tree</code>: equivalente a <code class="language-plaintext highlighter-rouge">git write-tree</code></li>
</ul>

<p>Deles, o primeiro não existe mais, ao menos não no seu nome original. Os últimos 4
ainda existem como comandos <em>plumbing</em> de baixo nível.</p>

<p>Ok, podemos brincar com ele.</p>

<h3 id="inicializando">Inicializando</h3>

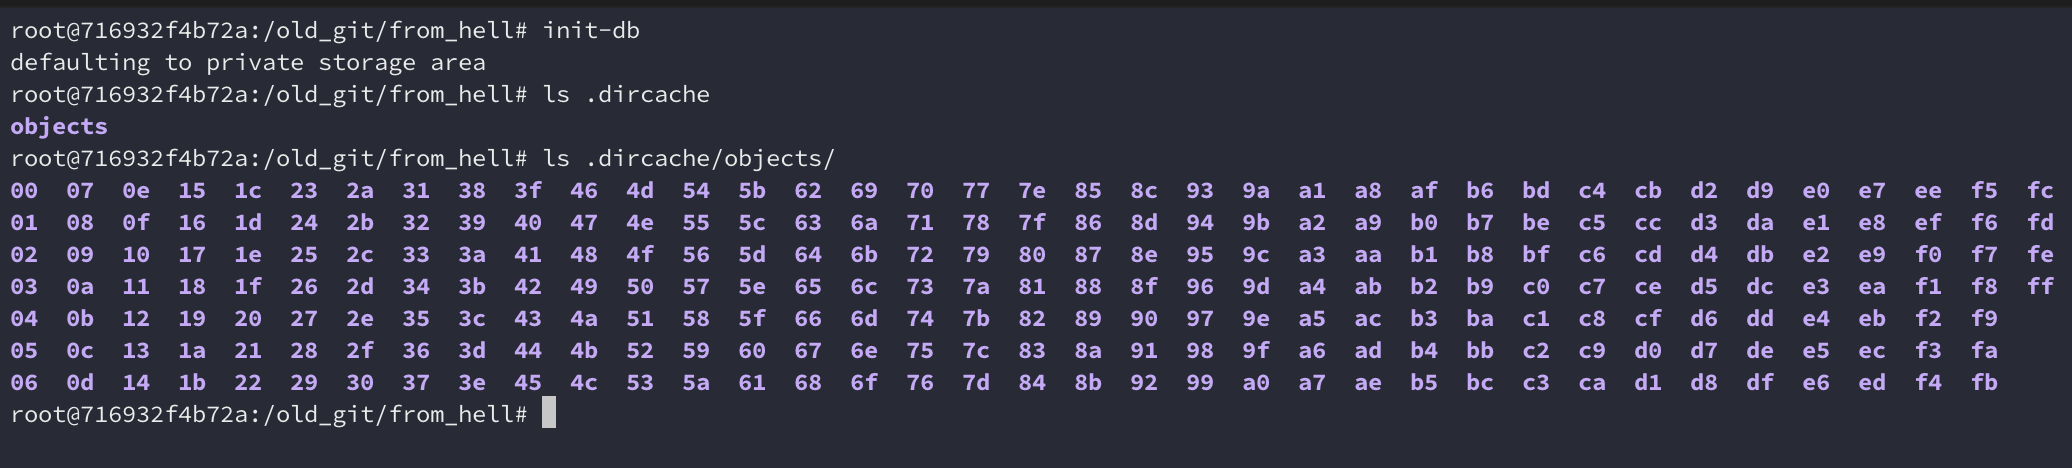
<p>Primeiramente, inicializei um repositório com <code class="language-plaintext highlighter-rouge">init-db</code>. Ele me mostrou uma
mensagem misteriosa “defaulting to private storage area”. Em vez de criar um
diretório <code class="language-plaintext highlighter-rouge">.git</code>, ele criou um diretório <code class="language-plaintext highlighter-rouge">.dircache</code> contendo apenas um
diretório <code class="language-plaintext highlighter-rouge">objects</code> parecido com o <code class="language-plaintext highlighter-rouge">.git/objects</code>, porém,
contendo todos os diretórios 00~ff por padrão:</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/dircache.png" alt="" /></p>

<h3 id="adicionando-um-código-c-simples-ao-index">Adicionando um código C simples ao index</h3>

<p>Antes de criarmos um commit, precisamos adicionar nossos arquivos à área de
staging (o index). Usamos <code class="language-plaintext highlighter-rouge">update-cache</code> para fazer isso, da mesma como hoje
fazemos com <code class="language-plaintext highlighter-rouge">git add</code>:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>update-cache fizzbuzz.c
</code></pre></div></div>

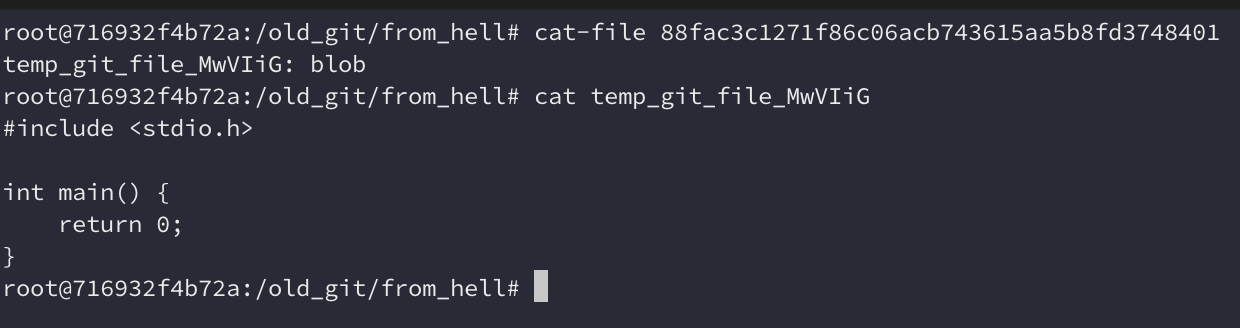
<p>Podemos ver que agora temos um arquivo <code class="language-plaintext highlighter-rouge">fac3c1271f86c06acb743615aa5b8fd3748401</code>
dentro de <code class="language-plaintext highlighter-rouge">.dircache/objects/88</code>, o que significa que foi criado um objeto
<code class="language-plaintext highlighter-rouge">88fac3c1271f86c06acb743615aa5b8fd3748401</code>. No Git moderno poderíamos
inspecioná-lo com <code class="language-plaintext highlighter-rouge">git cat-file -p</code> e ver os conteúdos desse objeto. Nesta
primeira versão é necessário usar <code class="language-plaintext highlighter-rouge">cat-file</code> e ele mostra que o objeto é um blob
(um conteúdo de um arquivo) e ele cria um arquivo temporário com seu conteúdo:</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/cat-file.png" alt="" /></p>

<p>Um novo arquivo <code class="language-plaintext highlighter-rouge">index</code> foi criado dentro de <code class="language-plaintext highlighter-rouge">.dircache</code>, assim como temos no
Git modeno. Não temos um comando para inspecioná-lo (como <code class="language-plaintext highlighter-rouge">git status</code> ou <code class="language-plaintext highlighter-rouge">git
ls-files</code>). Podemos usar <code class="language-plaintext highlighter-rouge">hexdump</code> aqui e ele mostra que esse arquivo mapeia
<code class="language-plaintext highlighter-rouge">fizzbuzz.c</code> ao blob criado. Então, parece estar tudo funcionando.</p>

<h3 id="criando-um-commit">Criando um commit</h3>

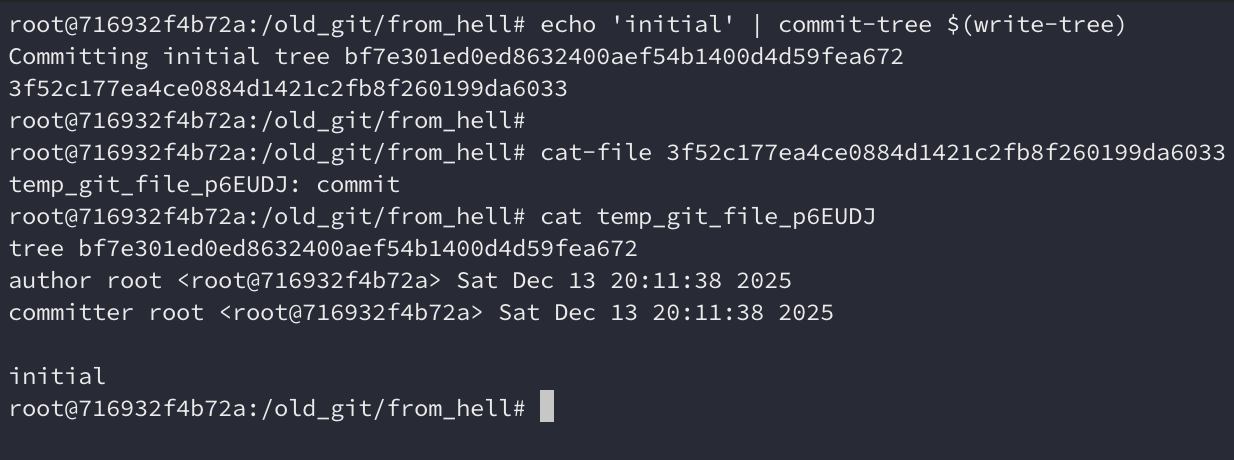
<p>Queremos agora criar um commit. Não temos <code class="language-plaintext highlighter-rouge">git commit</code> aqui, mas podemos fazer
isso de forma manual da mesma forma que no Git moderno poderíamos fazer com 
<code class="language-plaintext highlighter-rouge">git write-tree</code> + <code class="language-plaintext highlighter-rouge">git commit-tree</code> (
<a href="https://git-scm.com/book/en/v2/Git-Internals-Git-Objects">mais infos aqui</a>
). Essa versão já tem versões primitivas desses dois comandos, então vamos
usá-los.</p>

<p>Podemos ver através de <code class="language-plaintext highlighter-rouge">cat-file</code> que o commit foi criado com sucesso. Ele é
bastante similar aos commits modernos, porém, podemos ver que ele armazena as
datas e horas como texto em vez de um timestamp com timezone.</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/commit-tree.png" alt="" /></p>

<p>Dessa forma, a sequência <code class="language-plaintext highlighter-rouge">git add</code> + <code class="language-plaintext highlighter-rouge">git commit</code> seria:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># git add fizzbuzz.c</span>
update-cache fizzbuzz.c

<span class="c"># git commit -m "my commit"</span>
<span class="nb">echo</span> <span class="s2">"my commit"</span> | commit-tree <span class="si">$(</span>write-tree<span class="si">)</span> <span class="nt">-p</span> &lt;parent commit&gt;
</code></pre></div></div>

<h3 id="restaurando-o-conteúdo">Restaurando o conteúdo</h3>

<p>Não temos <code class="language-plaintext highlighter-rouge">git restore</code>, <code class="language-plaintext highlighter-rouge">git reset</code> ou <code class="language-plaintext highlighter-rouge">git checkout</code> aqui, então se quisermos
obter uma versão anterior de um arquivo precisamos fazê-lo atravées de
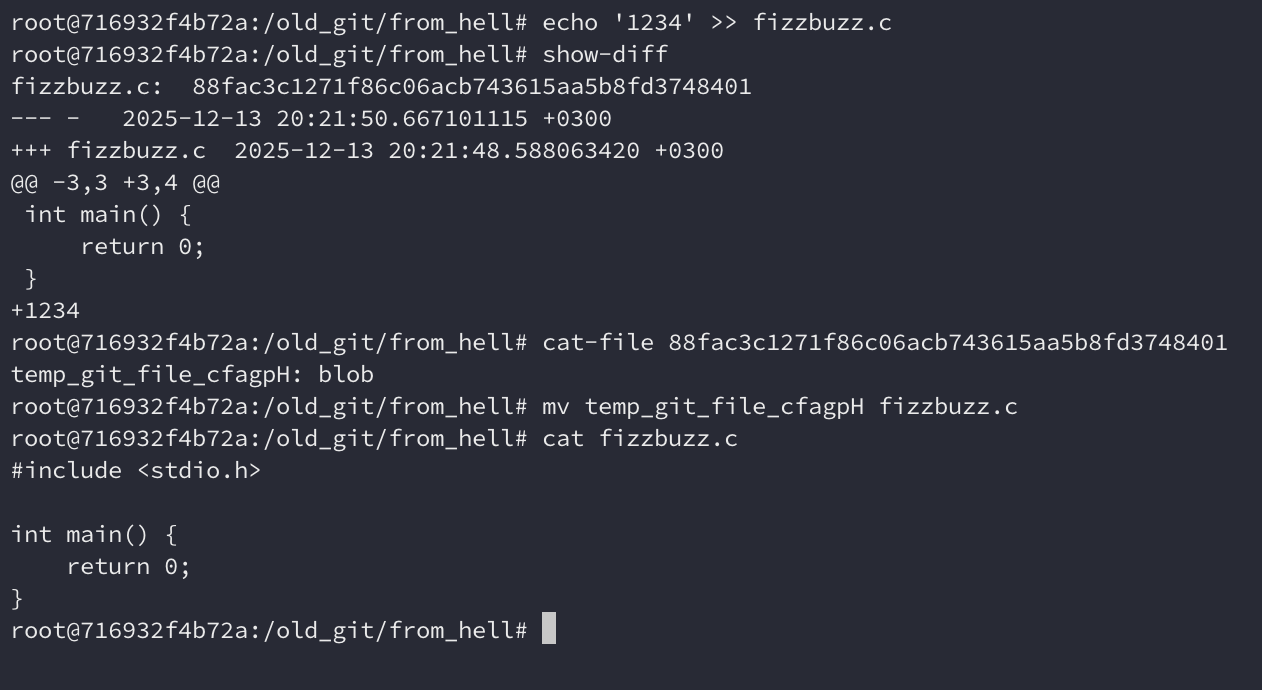
<code class="language-plaintext highlighter-rouge">cat-file</code>. Vamos alterar o <code class="language-plaintext highlighter-rouge">fizzbuzz.c</code> e tentar restaurá-lo. <code class="language-plaintext highlighter-rouge">show-diff</code> nos
mostra o diff em relação ao index, podemos usá-lo para ver as diferenças. Então,
é possível restaurar usando <code class="language-plaintext highlighter-rouge">cat-file</code>, mas para isso precisamos do hash do
blob.</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/show-diff.png" alt="" /></p>

<p>Mas e se quisermos restaurar o conteúdo de outro commit, como normalmente
fazemos com <code class="language-plaintext highlighter-rouge">git checkout</code>? Precisamos obter o commit, depois sua tree e por
fim, olhar os conteúdos da tree com <code class="language-plaintext highlighter-rouge">hexdump</code>, assim:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">commit_content</span><span class="o">=</span><span class="si">$(</span>cat-file &lt;commit&gt; | <span class="nb">cut</span> <span class="nt">-d</span> <span class="s1">':'</span> <span class="nt">-f</span> 1<span class="si">)</span>
<span class="nv">tree_hash</span><span class="o">=</span><span class="si">$(</span><span class="nb">cat</span> <span class="nv">$commit_content</span> | <span class="nb">head</span> <span class="nt">-n</span> 1 | <span class="nb">cut</span> <span class="nt">-d</span> <span class="s1">' '</span> <span class="nt">-f</span> 2<span class="si">)</span>
hexdump <span class="nt">-C</span> <span class="si">$(</span>cat-file <span class="nv">$tree_hash</span> | <span class="nb">cut</span> <span class="nt">-d</span> <span class="s1">':'</span> <span class="nt">-f</span> 1<span class="si">)</span>
</code></pre></div></div>

<p>Em nosso setup temos apenas um arquivo, então a tree só tem uma única entrada.
Desta forma, os últimos 20 bytes são o hash do blob que queremos. Se usarmos
<code class="language-plaintext highlighter-rouge">cat-file</code> para obter esse blob, podemos renomear o arquivo como <code class="language-plaintext highlighter-rouge">fizzbuzz.c</code>.</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">blob_hash</span><span class="o">=</span><span class="si">$(</span><span class="nb">tail</span> <span class="nt">-c</span> 20 &lt; <span class="si">$(</span>cat-file <span class="nv">$tree_hash</span> | <span class="nb">cut</span> <span class="nt">-d</span> <span class="s1">':'</span> <span class="nt">-f</span> 1<span class="si">)</span> | xxd <span class="nt">-p</span><span class="si">)</span>
<span class="nb">mv</span> <span class="si">$(</span>cat-file <span class="nv">$blob_hash</span> | <span class="nb">cut</span> <span class="nt">-d</span> <span class="s1">':'</span> <span class="nt">-f</span> 1<span class="si">)</span> fizzbuzz.c
</code></pre></div></div>

<h3 id="criando-os-outros-commits">Criando os outros commits</h3>

<p>A única diferença próximos commits antes do merge é que eles precisam
referenciar seu commit pai. Podemos fazer isso usando a mesma sequência de
<code class="language-plaintext highlighter-rouge">update-cache</code>, <code class="language-plaintext highlighter-rouge">write-tree</code> e <code class="language-plaintext highlighter-rouge">commit-tree</code>, porém, usando <code class="language-plaintext highlighter-rouge">-p &lt;pai&gt;</code> no
<code class="language-plaintext highlighter-rouge">commit-tree</code>, da mesma forma que no <code class="language-plaintext highlighter-rouge">git commit-tree</code> moderno.</p>

<p>Nosso histórico de commits está assim:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>* buzz
| * fizz
|/
* for
* initial
</code></pre></div></div>

<h3 id="merge">Merge</h3>

<p>Ainda não há um algoritmo de merge, temos que mesclar os arquivos manualmente e
criar o commit de merge. O commit de merge é um commit com dois pais, então
podemos usar a mesma sequência, mas fornecendo dois <code class="language-plaintext highlighter-rouge">-p &lt;parent&gt;</code> ao
commit-tree.</p>

<h3 id="compatibilidade">Compatibilidade</h3>

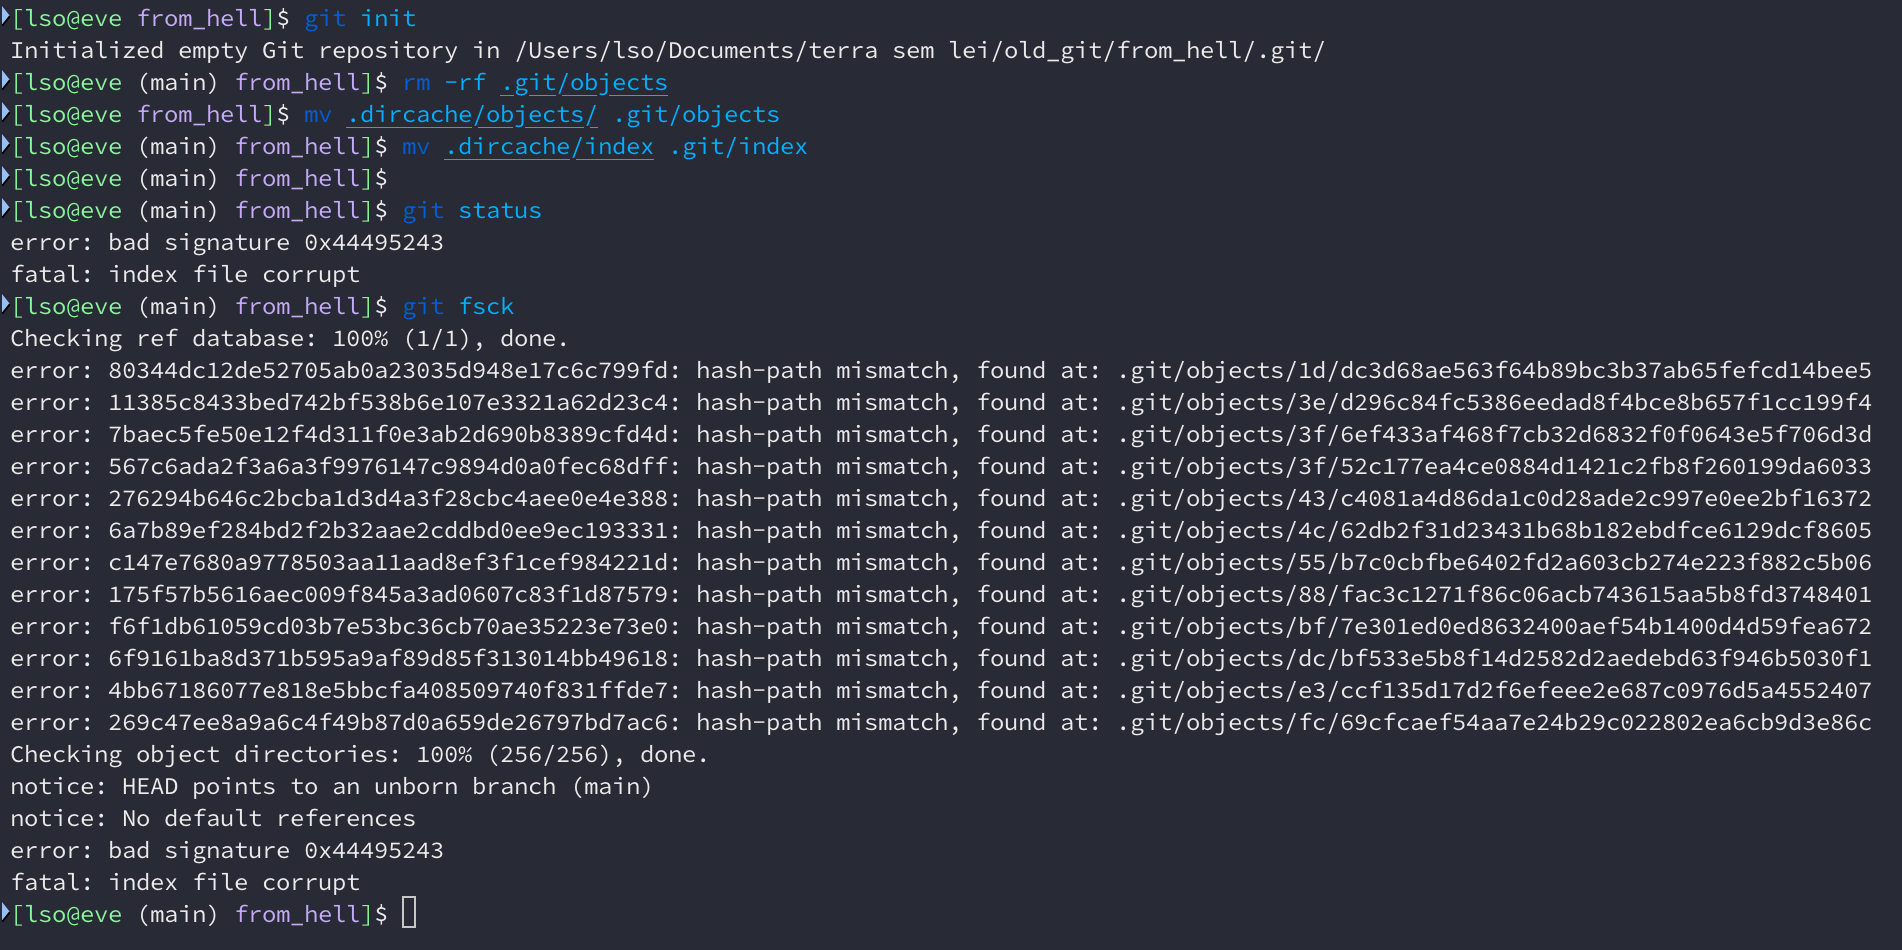
<p>Chegou a hora de saber se o repositório é compatível com um Git moderno (estou
usando 2.50.1). Podemos copiar o arquivo <code class="language-plaintext highlighter-rouge">index</code> e o diretório <code class="language-plaintext highlighter-rouge">objects</code> do
<code class="language-plaintext highlighter-rouge">.dircache</code> para um <code class="language-plaintext highlighter-rouge">.git</code> novo. Vamos ver o que acontece.</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/compatibility_hell.png" alt="" /></p>

<p>Ah não, todos os arquivos copiados são considerados quebrados pelo Git.
<code class="language-plaintext highlighter-rouge">git log</code> até funciona, mas <code class="language-plaintext highlighter-rouge">git checkout</code> não.</p>

<h3 id="head-e-branches">HEAD e branches</h3>

<p>Talvez você reparou que eu não mencionei nada sobre branches ou o commit atual
(<code class="language-plaintext highlighter-rouge">HEAD</code>). E isso é porque esses conceitos não existem ainda. Nós apenas operamos
a nível de objetos e index. É necessario saber o hash de cada commit.</p>

<h3 id="é-usável">É usável?</h3>

<p>Nem um pouco. Mesmo se você souber bem como manipular objetos do Git, você
precisará copiar os hash toda hora. É difícil de saber o que está acontecendo
com esses comandos primitivos e a falta de referências torna tudo realmente
difícil. Para ser um pouco mais usável você precisa escrever scripts para
manipular os objetos.</p>

<h2 id="a-última-versão-do-pai-do-git">A última versão do pai do Git</h2>

<p>O primeiro commit é fácil de encontrar, mas e quanto à última versão lançada por
Linus Torvalds? Precisamos ir um pouco mais fundo na história do Git e no
histórico de Git do Git para encontrar o que aconteceu.</p>

<p>Nossa primeira pista é a mensagem
<a href="https://lore.kernel.org/git/Pine.LNX.4.58.0507262004320.3227@g5.osdl.org/">“Meet the new maintainer”</a>
enviada do Linus para a lista de email do Git. Ela foi enviada em 15 de julho de
2005, apenas três meses após o primeiro commit. Podemos verificar as tags de
release próximas a essa data e ver quem as gerou:</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">v0.99</code> aponta para um commit feito pelo Junio, mas ainda assinado pelo
Linus. Essa tag não tem nenhuma informação de autor porque isso ainda não
tinha sido implementado, ainda ia levar alguns <em>dias</em> até que a informação do
tagger ser
<a href="https://lore.kernel.org/git/m17jfsyj8t.fsf@ebiederm.dsl.xmission.com/">introduzida aqui</a>!</li>
  <li><code class="language-plaintext highlighter-rouge">v0.99.1</code> tem Linus como autor e é a última versão antes do e-mail “Meet the
new maintainer”</li>
  <li><code class="language-plaintext highlighter-rouge">v0.99.2</code> tem Junio como autor e é assinado por ele</li>
</ul>

<p>Dessa forma, Linus só criou duas release do Git: <code class="language-plaintext highlighter-rouge">v0.99</code> (em 10 de julho) e
<code class="language-plaintext highlighter-rouge">v0.99.1</code> (em 15 de julho, apenas 5 dias depois). A primeira versão do Junio
(<code class="language-plaintext highlighter-rouge">v0.99.1</code>) foi lançada apenas duas semanas depois. Vale a pena notar que
<code class="language-plaintext highlighter-rouge">v0.99.1</code> é a última versão com Linus como <strong>maintainer</strong>, mas não a última em
que ele esteve envolvido. Na verdade, você pode ver com 
<code class="language-plaintext highlighter-rouge">git log --author='Linus Torvalds'</code> que ele enviou vários patches desde então.</p>

<p><code class="language-plaintext highlighter-rouge">v0.99.1</code> já tem o executável <code class="language-plaintext highlighter-rouge">git</code>, mas ele é apenas um script para chamar
outros comandos. Você verá que essa versão é muito mais familiar. Ele cresceu
bastante em tamanho, já tendo 20292 linhas de código C, 1092 linhas de código
Perl e 8673 linhas de shellscripts (incluindo testes).</p>

<p>Da mesma forma que o primeiro commit, ele não compila na primeira
tentativa. Precisei remover o <code class="language-plaintext highlighter-rouge">git-http-push</code> do Makefile, já que eu não
precisava dele e ele estava quebrando o build.</p>

<h3 id="inicializando-1">Inicializando</h3>

<p>Agora todos os comandos estão debaixo do comando <code class="language-plaintext highlighter-rouge">git</code>, da mesma forma que o
Git moderno (ainda que possamos chamar eles diretamente). Também agora
<code class="language-plaintext highlighter-rouge">git init-db</code> gera um diretório <code class="language-plaintext highlighter-rouge">.git</code> contendo a <code class="language-plaintext highlighter-rouge">HEAD</code> e o diretório <code class="language-plaintext highlighter-rouge">refs</code>
(onde ficam as branches e tags). Nesta versão, HEAD é um symlink para a branch
que ela aponta, ao contrário de outras versões mais novas do Git onde ela é um
arquivo de texto puro.</p>

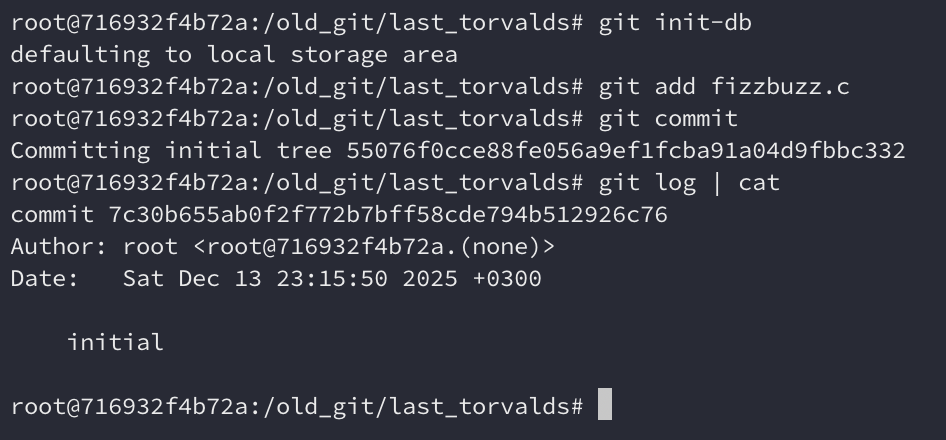
<h3 id="adicionando-ao-index-and-criando-commits">Adicionando ao index and criando commits</h3>

<p>Nesta versão, o Git já tem <code class="language-plaintext highlighter-rouge">git add</code> e <code class="language-plaintext highlighter-rouge">git commit</code>. <code class="language-plaintext highlighter-rouge">git status</code> existe, mas
não funciona se não temos pelo menos um commit no nosso histórico. Também temos
<code class="language-plaintext highlighter-rouge">git log</code>, mas ela não mostra o nome da branch.</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/last_commit.png" alt="" /></p>

<h3 id="restaurando-os-conteúdos-de-um-arquivo">Restaurando os conteúdos de um arquivo</h3>

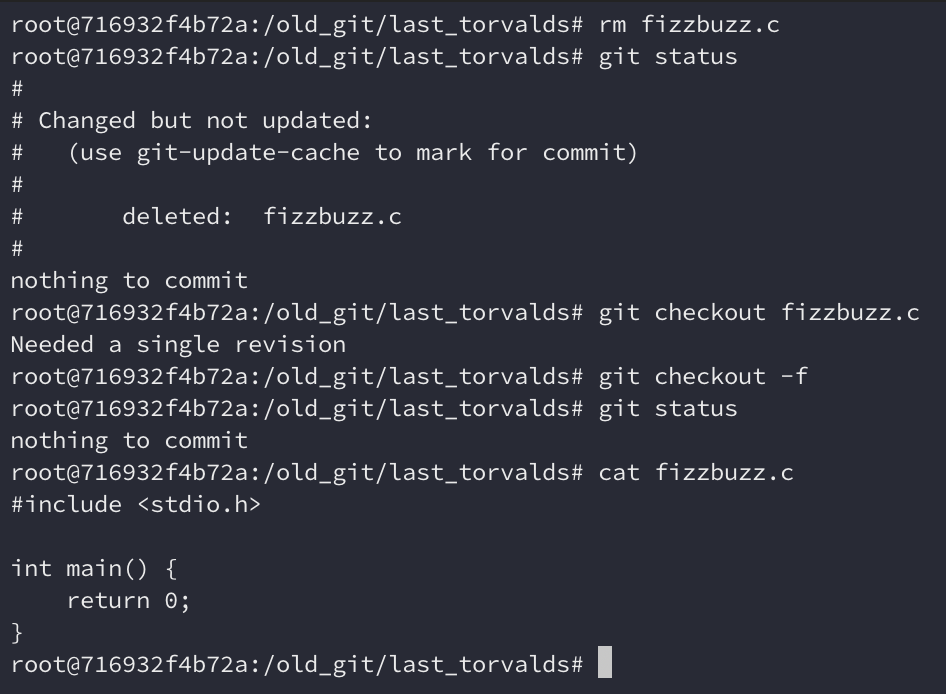
<p>Se tivermos um commit, <code class="language-plaintext highlighter-rouge">git status</code> funciona. Ele nos diz que <code class="language-plaintext highlighter-rouge">fizzbuzz.c</code> foi
deletado, e que podemos restaurá-lo usando <code class="language-plaintext highlighter-rouge">git checkout -f</code>. Legal.</p>

<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/last_checkout.png" alt="" /></p>

<h3 id="criando-outros-commits-e-branches">Criando outros commits e branches</h3>

<p>Como já temos <code class="language-plaintext highlighter-rouge">git add</code> e <code class="language-plaintext highlighter-rouge">git commit</code>, não precisamos ficar brincando com
comandos plumbing para criar novos commits. Também podemos criar novas branches
com <code class="language-plaintext highlighter-rouge">git checkout -b</code> ou <code class="language-plaintext highlighter-rouge">git branch</code> e navegar entre eles usando
<code class="language-plaintext highlighter-rouge">git checkout</code>, então essa etapa é realmente como se estivéssemos usando o Git
moderno. O <code class="language-plaintext highlighter-rouge">git checkout</code>, porém, ainda não consegue entrar em detached HEAD.</p>

<p>Porém, <code class="language-plaintext highlighter-rouge">git rev-parse</code>, <code class="language-plaintext highlighter-rouge">git log</code> e <code class="language-plaintext highlighter-rouge">git branch</code> não mostram o conteúdo da
branch atual e <code class="language-plaintext highlighter-rouge">git-symbolic-ref</code> também não existe ainda. A única forma que
consegui descobrir a branch atual foi olhando direto o link simbólico <code class="language-plaintext highlighter-rouge">.git/HEAD</code>.</p>

<h3 id="merge-1">Merge</h3>

<p><code class="language-plaintext highlighter-rouge">git merge</code> ainda não existe, mas o README diz como fazer um merge manual usando
<code class="language-plaintext highlighter-rouge">git read-tree</code>. Também temos um script que o Linus escreveu para tornar isso
mais fácil, chamado <code class="language-plaintext highlighter-rouge">git resolve</code>. Internamente, ele depende do comando <code class="language-plaintext highlighter-rouge">merge</code>
do <a href="https://www.gnu.org/software/rcs/">GNU RCS</a>, então precisamos dele instalado.
Ele conseguiu mesclar as duas branches corretamente.</p>

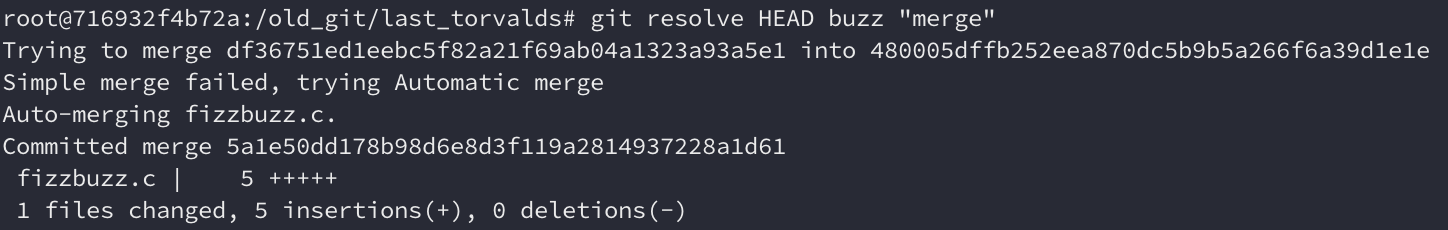
<p><img src="/assets/images/posts/2025-12-12-using-torvalds-git/last_resolve.png" alt="" /></p>

<h3 id="compatibilidade-1">Compatibilidade</h3>

<p>Aparentemente tudo parece funcionar normal quando abro este repositório com o
Git 2.50. Mas este repositório é bem simples e com um único arquivo, não sei o
que acontece com repositórios mais complexos.</p>

<h3 id="é-usável-1">É usável?</h3>

<p>Se você sabe o que está fazendo, esta versão já é usável. Mas você precisa
realmente saber o que está fazendo, as mensagens de erro não ajudam
muito. Outros recursos importantes do Git ainda não foram implementados, então,
mesmo que ele seja familiar, é necessário entender o funcionamento interno do
Git para usá-lo.</p>

<h2 id="conclusão">Conclusão</h2>

<p>É sempre legal ver o nascimento de algo grandioso. A primeira versão do Git era
apenas um conjunto simples de utilitários para manipular alguns arquivos, mas já
continha o miolo que torna o Git excelente. A última versão do Git do Torvalds
já era muito mais usável e, mesmo que ainda parecesse um tanto frágil, já
parecia ser usável o suficiente para ser usada por alguém que realmente sabia o
que estava fazendo. Linus certamente sabia e o usou para versionar o Linux.</p>

<p>Ainda que o Linus Torvalds seja lembrado como o pai do Git, a última versão sob
sua liderança não era exatamente o Git que conhecemos hoje em dia. Porém, é
claro, isso foi um começo incrível e é impressionante o que ele e a comunidade
construíram nesses três primeiros meses.</p>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Voltando a 2005 para ver o que estava acontecendo]]></summary></entry><entry xml:lang="pt_br"><title type="html">Git: the danger of squash merging submodules</title><link href="https://lucasoshiro.github.io/posts/2024-06-27-squash-submodule/" rel="alternate" type="text/html" title="Git: the danger of squash merging submodules" /><published>2024-06-27T00:00:00+00:00</published><updated>2024-06-27T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/squash-submodule</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2024-06-27-squash-submodule/"><![CDATA[<p><strong>TRADUÇÃO INCOMPLETA</strong></p>

<h2 id="intro">Intro</h2>

<p>Git submodules are something that haunts me. They are a pain, but sometimes they are
the only available solution. But, well, they work if used carefully.</p>

<p>However, not everyone use them carefully. I mean, I can’t remember how many
times I needed to explain that submodules point to commits instead of
branches… But I can’t blame them, it took me a some time to <em>really</em>
understand how work, even if I used them everyday. And there are even more
things that aren’t so well-known about submodules, for example, how Git merges
them, as I explained <a href="/posts-en/2022-03-12-merge-submodule">here</a>.</p>

<!-- Melhorar -->
<p>So, here I’ll show a situation that I once saw.</p>

<h3 id="goals">Goals</h3>

<ul>
  <li>
    <p>Discourage the use of <strong>squash merge</strong> in repositories that have <strong>submodules</strong>;</p>
  </li>
  <li>
    <p>Show how <strong>squash merges</strong> can break repositories that uses submodules.</p>
  </li>
</ul>

<h3 id="non-goals">Non-Goals</h3>

<ul>
  <li>
    <p>Explain how submodules work. I did that <a href="/posts-en/2022-03-12-merge-submodule/#brief-explanation-about-submodules">here</a>.</p>
  </li>
  <li>
    <p>Discourage the use of squash merge in a general way. I did that <a href="/posts-en/2024-04-08-please_dont_squash">here</a>.</p>
  </li>
  <li>
    <p>Discourage the use of submodules.</p>
  </li>
</ul>

<h2 id="the-situation">The situation</h2>

<p>Imagine this situation: you have a <strong>project A</strong> that has a <strong>project B</strong> as a
submodule. Imagine that you have a feature that need to be developed in both A
and B to work. Let’s assume that on both repositories you have a <code class="language-plaintext highlighter-rouge">main</code> branch.</p>

<h3 id="a-safe-workflow">A safe workflow</h3>

<p>A safe workflow is this:</p>

<ol>
  <li>develop the new feature in a branch <strong>X</strong> in <em>*B</em>;</li>
  <li>wait for review and approval of <strong>X</strong>, then merge <strong>X</strong> on <strong>B’s main</strong>;</li>
  <li>develop the new feature in a branch <strong>Y</strong> in <strong>A</strong>,  making it point to <strong>B’s main</strong>;</li>
  <li>wait for review and approval of <strong>Y</strong>, then merge <strong>Y</strong> on <strong>A’s main</strong>;</li>
  <li>deploy.</li>
</ol>

<p>Remember submodules don’t point to branches, they point to <strong>commits</strong>. When we
make <strong>Y</strong> point to <strong>B’s main</strong> we’re actually making it point to the commit
that B’s main references. If are not familiar with this concept, I discussed
about how submodules work
<a href="/posts-en/2022-03-12-merge-submodule/#brief-explanation-about-submodules">here</a>.</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-06-27-squash-submodule/submodule_merge-en.svg" />
    <figcaption>The safe workflow. A is in blue, B is in red, and the dotted arrows are the submodule references</figcaption>
  </figure>
</div>

<p>That is an ideal workflow, but it may be to slow as you need to wait the
approval <em>without</em> writing the new code of Y.</p>

<h3 id="a-faster-workflow">A faster workflow</h3>

<p>Waiting <strong>X</strong> to be approved and merged takes time, and sometimes we don’t want
to be blocked by it. We can use that wait time to develop our new feature in
<strong>A</strong>, by pointing to <strong>X</strong> instead of the <strong>B’s main</strong>:</p>

<ol>
  <li>develop the new feature in a branch <strong>X</strong> in <strong>B</strong>, just like before;</li>
  <li>develop the new feature in a branch <strong>Y</strong> in <strong>A</strong>,  making it point to <strong>X</strong>;</li>
  <li>wait for review and approval of <strong>X</strong>, then merge X on <strong>B’s main</strong>;</li>
  <li>make <strong>Y</strong> point to <strong>B’s</strong> main, as it now contains the new feature;</li>
  <li>wait for review and approval of <strong>Y</strong>, then merge Y on <strong>A’s main</strong>;</li>
  <li>deploy.</li>
</ol>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-06-27-squash-submodule/submodule_merge_faster-en.svg" />
    <figcaption>A faster workflow. It's not wrong, but you need to be careful when doing this </figcaption>
  </figure>
</div>

<p>No problem in doing that. If we follow that, in <strong>step 5</strong> the three-way merge
algorithm will make <strong>A’s main</strong> point to <strong>B’s main</strong>, as I explained 
<a href="/posts-en/2022-03-12-merge-submodule/#brief-explanation-about-submodules">here</a>.</p>

<p>However, <strong>step 4</strong> is easy to forget: <strong>A</strong> works when it is pointing to <strong>X</strong>,
so, it is easy to forget to make it point to <strong>B’s main</strong> after <strong>X</strong> is
merged. After that, <strong>step 5</strong> would point to <strong>X</strong> instead of <strong>B’s main</strong>:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-06-27-squash-submodule/submodule_merge_step_5_wihout_4-en.svg" />
    <figcaption> Step 5 of the faster workflow without step 4. </figcaption>
  </figure>
</div>

<p>Note that doing that code won’t break the code. <strong>A’s main</strong> will point to
<strong>X</strong>, and it has the <strong>same</strong> code that it had previously plus the changes that
were introduced in X. The only drawback here would be that A’s main would not
be referencing the latest commit pointed by B’s main.</p>

<p>In fact, even though it looks wrong and it’s not the ideal situation, it won’t
break anything, as after <strong>X</strong> was merged on <strong>B’s main</strong>, the commit pointed by
<strong>X</strong> will be an ancestor of <strong>B’s main</strong>. This way, <strong>A</strong> would be referencing
what can be considered an older version of <strong>B’s main</strong>. The order of the parent
commits of a merge commit doesn’t matter here, and that’s one of the beauties of Git.</p>

<h3 id="but">But…</h3>

<p>But it works because the commit pointed by <strong>X</strong> is still reachable from
<strong>B’s main</strong>. And this is because we performed a <strong>true merge</strong>, keeping a
reference to the merged branch.</p>

<p>This is not what would happen if we performed a
<strong>squash merge</strong>, as the <strong>squash merge</strong> is the same as the <strong>true merge</strong> except that 
it <strong>doesn’t keep the reference to the merged branch</strong>, as I explained
<a href="/posts-en/2024-04-08-please_dont_squash">here</a>.</p>

<p>Then, things can break if you replace the merge in 3 by a squash merge. After
merging a PR (true merge, squash merge or fast forward) on GitHub, this shows
up:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-06-27-squash-submodule/delete_branch.png" />
    <figcaption> A delete branch button </figcaption>
  </figure>
</div>

<p>It’s reasonable to click on it, as the code is already merged and you won’t need
that reference anymore.</p>

<p>So, let’s imagine the sitation where we replaced the merge in step 3 by a
<strong>squash merge</strong> and then clicked that button to delete X. Then, we proceed to
step 5, where we merge Y on A’s main.</p>

<p>Supposing that even if the code worked for both the reviewers and the author, it
will <strong>break</strong> if we try to deploy in that situation.</p>

<p>And it’s worse: <strong>it only works</strong> on the machines where the people who developed
and reviewed the code before 5, but it <strong>won’t work</strong> on other machines! This
way, both the reviewers and the developers will swear that the code <strong>works</strong>
while everyone else clearly see that it is <strong>broken</strong>!</p>

<h3 id="whats-happening">What’s happening???</h3>

<p>Remember that when you perform a <strong>squash merge</strong> you don’t reference the commit
pointed by the original branch? If you delete the original branch (that is also
a reference) on GitHub or similar you’ll <strong>lose</strong> the last remaining reference
to that commit on the <strong>remote</strong> repository, but you won’t lose in the machines
that still have <strong>X</strong>.</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-06-27-squash-submodule/submodule_squash-en.svg" />
    <figcaption><i> The previous situation, but using squash merge </i></figcaption>
  </figure>
</div>

<p>When a commit is not reachable by any reference (normally, branches and tags) of
its repository, it can’t be fetched as <code class="language-plaintext highlighter-rouge">git fetch</code> (and of course, <code class="language-plaintext highlighter-rouge">git pull</code> or
<code class="language-plaintext highlighter-rouge">git clone</code>) only fetches given a reference. Not only that, but eventually that
commit will be deleted as it is unreachable (see 
<a href="https://git-scm.com/docs/git-gc">git gc</a>). It means that the <strong>commit pointed
as submodule by A’s main is lost</strong>. This way, the code will <strong>depend on
something that doesn’t exist</strong> anymore! And, of course, if it depends on
something that doesn’t exist it won’t work!</p>

<h2 id="conclusion">Conclusion</h2>

<p>Code that only works on the developer and the reviewer machines but not on other
machines is a nightmare. This is a new level of <strong>“but it works on my machine”</strong>
because even if you have the exact same setup as the developer, the code will
break, as the problem is a commit that doesn’t exist anymore.</p>

<p>So, if someone uses your code as a submodule, stopping using squash is not
enough. I ask you: <strong>DISABLE</strong> the option to squash if you can on GitHub or
similar. This is <strong>harmful</strong>.</p>

<p>Thanks for your time! I hope that this may be useful.
If something is wrong, please open a
<a href="https://github.com/lucasoshiro/lucasoshiro.github.io/issues">issue</a>.</p>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Or: how to silently break your deploy]]></summary></entry><entry xml:lang="pt_br"><title type="html">Ruby: uma ótima linguagem para shell scripts!</title><link href="https://lucasoshiro.github.io/posts/2024-06-17-ruby-shellscript/" rel="alternate" type="text/html" title="Ruby: uma ótima linguagem para shell scripts!" /><published>2024-06-17T00:00:00+00:00</published><updated>2024-06-17T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/ruby-shellscript</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2024-06-17-ruby-shellscript/"><![CDATA[<h2 id="introdução">Introdução</h2>

<p>Ruby é tão associada com seu framework mais famoso, Rails, que muitas pessoas
esquecem o quanto incrível essa linguagem é. Quero dizer, eu conheço muita gente
que diz “eu não gosto de Ruby” e quando eu pergunto o porquê, eles dizem alguma
coisa sobre o Rails. Pessoalmente, considero Ruby uma das minhas linguagens de
programação preferidas, e a última vez que eu encostei em algum código de Rails
foi há 7 anos…</p>

<p>Então, se eu não uso mais Rails, o que é que eu faço com Ruby? Bem, Ruby é uma
linguagem bem rica e completa, talvez até mais que sua parente mais famosa,
Python (infelizmente, não posso dizer a mesma coisa sobre seu ecossistema…). 
E uma das coisas que eu considero que Ruby é melhor que Python é para escrever
shell scripts.</p>

<p>Isso é, na maior parte dos casos Bash é suficiente pra mim, mas se o script
começa a ficar complexo, então eu vou para Ruby. Aqui vou mostrar as principais
<em>features</em> da linguagem para esse caso de uso.</p>

<h3 id="objetivos">Objetivos</h3>

<ul>
  <li>
    <p>Mostrar features de Ruby que possam ser úteis para escrever shell scripts;</p>
  </li>
  <li>
    <p>Comparar Ruby com Bash e Python;</p>
  </li>
</ul>

<h3 id="não-objetivos">Não-objetivos</h3>

<ul>
  <li>Substituir <em>completamente</em> scripts Bash por scripts Ruby.</li>
</ul>

<h2 id="feature-1-chamar-comandos-externos">Feature 1: chamar comandos externos</h2>

<p>A primeira coisa que você espera de uma linguagem para escrever shell scripts é
chamar comandos externos. Em Ruby, você pode fazer isso usando backticks (<code class="language-plaintext highlighter-rouge">`</code>):</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="sb">`ls`</span>
</code></pre></div></div>

<p>E é isso! Você não precisa de <code class="language-plaintext highlighter-rouge">system</code>, <code class="language-plaintext highlighter-rouge">popen</code> ou similares, ou importar uma
biblioteca. E se você atribuir isso a uma variável, você terá a saída do
comando:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">my_date</span><span class="o">=</span><span class="sb">`date`</span>
</code></pre></div></div>

<blockquote>
  <p>Nota: se você quiser usar <code class="language-plaintext highlighter-rouge">system</code> (ex: se você quer que a saída seja
redirecionada para o stdout em vez de uma string) ou <code class="language-plaintext highlighter-rouge">popen</code> (se você quiser
ler e escrever dados de ou para um subprocesso), eles também estão disponíveis
em Ruby!</p>
</blockquote>

<h2 id="feature-2-status-code">Feature 2: status code</h2>

<p>Este é bem rápido: em Ruby, a variável <code class="language-plaintext highlighter-rouge">$?</code> contém o status code do último
comando executado. Então, é bem próximo de Bash:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="sb">`true`</span>
<span class="nb">puts</span> <span class="vg">$?</span> <span class="c1"># 0</span>

<span class="sb">`false`</span>
<span class="nb">puts</span> <span class="vg">$?</span> <span class="c1"># 1</span>
</code></pre></div></div>

<h2 id="feature-3-ruby-tem-tipos">Feature 3: Ruby tem tipos</h2>

<p>Ruby não é uma linguagem <em>estaticamente</em> tipada, mas tem tipos. Na verdade, é
uma linguagem orientada a objetos e segue estritamente o paradigma de POO (mais
que Python, em alguns aspectos até mais do que Java!). Bash, por outro lado,
tudo é uma string, e isso leva a vários problemas de segurança…</p>

<p>Então, você pode tirar proveito disso:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">total_lines</span> <span class="o">=</span> <span class="sb">`wc -l my_file`</span><span class="p">.</span><span class="nf">to_i</span> <span class="c1"># um int contendo o número de linhas de um arquivo</span>
<span class="n">half</span> <span class="o">=</span> <span class="n">total_lines</span><span class="p">.</span><span class="nf">div</span> <span class="mi">2</span>           <span class="c1"># divisão inteira</span>
<span class="nb">puts</span> <span class="sb">`head -n </span><span class="si">#{</span><span class="n">half</span><span class="si">}</span><span class="sb"> my_file`</span>     <span class="c1"># imprime metade de um arquivo</span>
</code></pre></div></div>

<h2 id="feature-4-construções-funcionais">Feature 4: construções funcionais</h2>

<p>Ruby implementa <code class="language-plaintext highlighter-rouge">map</code>, <code class="language-plaintext highlighter-rouge">select</code> (filter), <code class="language-plaintext highlighter-rouge">reduce</code>, <code class="language-plaintext highlighter-rouge">flat_map</code> e outras
operações funcionais como métodos. Então, você pode, por exemplo, aplicar um
<code class="language-plaintext highlighter-rouge">map</code> sobre a saída de um comando:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">puts</span> <span class="sb">`ls`</span><span class="p">.</span><span class="nf">lines</span><span class="p">.</span><span class="nf">map</span> <span class="p">{</span> <span class="o">|</span><span class="nb">name</span><span class="o">|</span> <span class="nb">name</span><span class="p">.</span><span class="nf">strip</span><span class="p">.</span><span class="nf">length</span> <span class="p">}</span> <span class="c1"># imprime os comprimentos dos nomes de arquivos.</span>
</code></pre></div></div>

<h2 id="feature-5-casamento-de-regex">Feature 5: casamento de regex</h2>

<p>Regex é um tipo em Ruby, e as operações usando regex são parte da
linguagem. Olhe este exemplo, em que a gente obtêm o nome da branch atual do Git
chamando <code class="language-plaintext highlighter-rouge">git branch</code>:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">current_branch_regex</span> <span class="o">=</span> <span class="sr">/^\* (\S+)/</span>
<span class="n">output_lines</span> <span class="o">=</span> <span class="sb">`git branch`</span><span class="p">.</span><span class="nf">lines</span>
<span class="n">output_lines</span><span class="p">.</span><span class="nf">each</span> <span class="k">do</span> <span class="o">|</span><span class="n">line</span><span class="o">|</span>
  <span class="k">if</span> <span class="n">line</span> <span class="o">=~</span> <span class="n">current_branch_regex</span> <span class="c1"># casa a string com a regex</span>
    <span class="nb">puts</span> <span class="vg">$1</span>                       <span class="c1"># imprime o primeiro grupo</span>
  <span class="k">end</span>
<span class="k">end</span>
</code></pre></div></div>

<blockquote>
  <p>Nota para amantes de Git: eu sei que eu podia ter feito isso usando <code class="language-plaintext highlighter-rouge">git
branch --show current</code>, mas esse foi o primeiro exemplo que veio na minha
cabeça para demonstrar o uso de regex…</p>
</blockquote>

<h2 id="feature-6-threads-fáceis">Feature 6: threads fáceis</h2>

<p>Se você quer trabalhar com várias threads, Ruby é talvez a linguagem mais fácil
de fazer isso. Veja:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">thread</span> <span class="o">=</span> <span class="no">Thread</span><span class="p">.</span><span class="nf">new</span> <span class="k">do</span>
    <span class="nb">puts</span> <span class="s2">"Estou dentro da thread!"</span>
<span class="k">end</span>

<span class="nb">puts</span> <span class="s2">"Estou fora da thread!"</span>

<span class="n">thread</span><span class="p">.</span><span class="nf">join</span>
</code></pre></div></div>

<p>Então, isso pode ser útil, por exemplo, para baixar vários arquivos ao mesmo
tempo:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">(</span><span class="mi">1</span><span class="o">..</span><span class="mi">10</span><span class="p">).</span><span class="nf">map</span> <span class="k">do</span> <span class="o">|</span><span class="n">i</span><span class="o">|</span>                       <span class="c1"># itera de i=1 a i=10, inclusivamente</span>
  <span class="no">Thread</span><span class="p">.</span><span class="nf">new</span> <span class="k">do</span>
    <span class="sb">`wget http://my_site.com/file_</span><span class="si">#{</span><span class="n">i</span><span class="si">}</span><span class="sb">`</span>  <span class="c1"># você pode usar variáveis dentro de comandos!  </span>
  <span class="k">end</span>
<span class="k">end</span><span class="p">.</span><span class="nf">each</span> <span class="p">{</span> <span class="o">|</span><span class="n">thread</span><span class="o">|</span> <span class="n">thread</span><span class="p">.</span><span class="nf">join</span> <span class="p">}</span>        <span class="c1"># do/end e chaves servem para a mesma coisa</span>
</code></pre></div></div>

<h2 id="feature-7-operações-de-arquivo-e-diretório-embutidas">Feature 7: operações de arquivo e diretório embutidas</h2>

<p>Em Ruby, todas as operações de arquivos são métodos da classe <code class="language-plaintext highlighter-rouge">File</code> e todas as
operações de diretório são métodos da classe <code class="language-plaintext highlighter-rouge">Dir</code>, como deveriam ser. Em
Python, por exemplo, se você quer ler um arquivo você usa <code class="language-plaintext highlighter-rouge">open</code>, mas se você
quer apagá-lo você precisa usar <code class="language-plaintext highlighter-rouge">os.remove</code>, e <code class="language-plaintext highlighter-rouge">os</code> tem várias outras coisas
que não são relacionadas a arquivos.</p>

<p>Então, em Ruby:</p>

<div class="language-ruby highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">exists</span> <span class="o">=</span> <span class="no">File</span><span class="p">.</span><span class="nf">exist?</span> <span class="s1">'My File'</span>           <span class="c1"># métodos que retornam booleanos são terminados em ?</span>
<span class="n">file_content</span> <span class="o">=</span> <span class="no">File</span><span class="p">.</span><span class="nf">open</span><span class="p">(</span><span class="s1">'My File'</span><span class="p">).</span><span class="nf">read</span>
<span class="no">File</span><span class="p">.</span><span class="nf">delete</span> <span class="s1">'My File'</span>                     <span class="c1"># parênteses são opcionais se não há ambiguidade</span>
</code></pre></div></div>

<h2 id="conclusão">Conclusão</h2>

<p>Espero que depois de ler este pequeno texto você considere usar Ruby como uma
substituta para shell scripts complexos. Quero dizer, não espero que você deixe
o Bash completamente, mas considere usar Ruby quando as coisas ficarem mais
complexas. Claro que você poderia fazer isso tudo em Python, Perl, até JS, mas,
como minha principal escolha eu acredito que Ruby é a escolha mais fácil e
completa para isso!</p>

<p>Se você encontrou alguma coisa errada, ou se você tem alguma sugestão, por favor
me diga <a href="https://github.com/lucasoshiro/lucasoshiro.github.io/issues">aqui</a>.</p>

<h2 id="update">Update</h2>

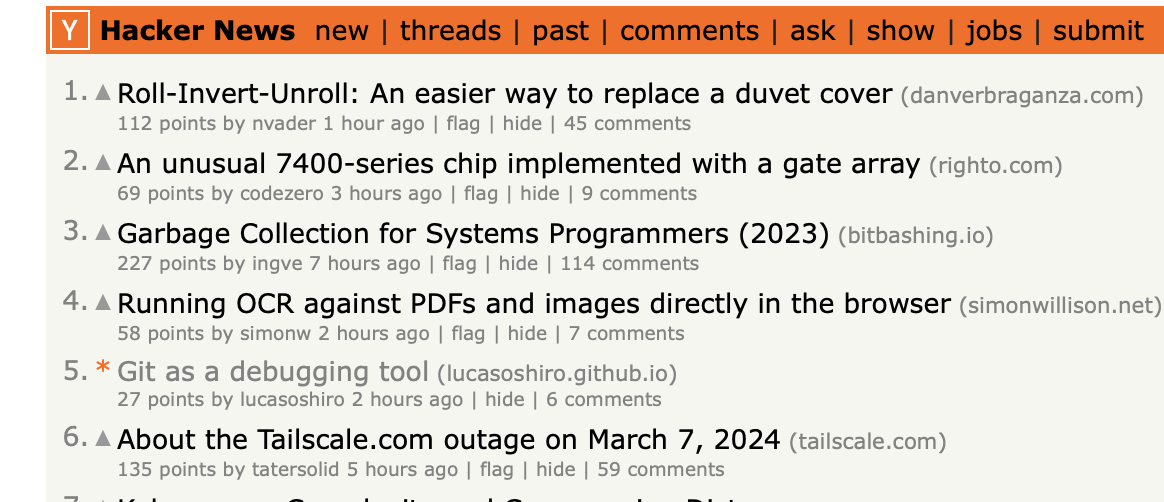
<p>Isto ficou em primeiro no <a href="https://news.ycombinator.com/item?id=40763640">Hacker News</a>!  Não apenas isso, mas
começou discussões bem interessante nos comentários. Obrigado a todos!</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-06-17-ruby-shellscript/hn.png" />
    <figcaption>#1 no HN!</figcaption>
  </figure>
</div>

<h2 id="update-2">Update #2</h2>

<p>De alguma forma isto chegou no Matz, o criador de Ruby! E isso foi twitado por
ele! Eu… não acredito!</p>

<blockquote class="twitter-tweet"><p lang="en" dir="ltr">Link: Ruby: a great language for shell scripts! - Lucas Seiki Oshiro : <a href="https://t.co/lestntomSR">https://t.co/lestntomSR</a><br /> <a href="https://t.co/lestntomSR">https://t.co/lestntomSR</a></p>&mdash; Yukihiro Matz (@yukihiro_matz) <a href="https://twitter.com/yukihiro_matz/status/1805475764013252815?ref_src=twsrc%5Etfw">June 25, 2024</a></blockquote>
<script async="" src="https://platform.twitter.com/widgets.js" charset="utf-8"></script>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[É mais do que o Rails]]></summary></entry><entry xml:lang="pt_br"><title type="html">Python: 10 truques legais com o operador *</title><link href="https://lucasoshiro.github.io/posts/2024-05-11-splat-operator/" rel="alternate" type="text/html" title="Python: 10 truques legais com o operador *" /><published>2024-05-11T00:00:00+00:00</published><updated>2024-05-11T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/splat-operator</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2024-05-11-splat-operator/"><![CDATA[<h2 id="introdução">Introdução</h2>

<p>Você provavelmente já o conhece, mas de qualquer forma, o operador unário (<code class="language-plaintext highlighter-rouge">*</code>)
em Python (também conhecido como operador <em>splat</em> ) expande qualquer iterável
(exemplos: listas, tuplas, conjuntos ou geradores) em argumentos posicionais de
funções. Por exemplo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">sum3</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">a</span> <span class="o">+</span> <span class="n">b</span> <span class="o">+</span> <span class="n">c</span>
    
<span class="n">my_list</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">]</span>
<span class="n">sum3</span><span class="p">(</span><span class="o">*</span><span class="n">my_list</span><span class="p">)</span> <span class="c1"># = sum3(1, 2, 3) = 6
</span><span class="n">sum3</span><span class="p">(</span><span class="o">*</span><span class="nb">range</span><span class="p">(</span><span class="mi">3</span><span class="p">))</span> <span class="c1"># = sum3(0, 1, 2) = 3
</span></code></pre></div></div>

<p>Também existe o operador <code class="language-plaintext highlighter-rouge">**</code>, ele expande 
<a href="https://docs.python.org/3/glossary.html#term-mapping">mapeamentos</a> (isto é, um
objeto que mapeia uma chaves a valaores, como um <code class="language-plaintext highlighter-rouge">dict</code>, um <code class="language-plaintext highlighter-rouge">orderedDict</code> ou até
um <code class="language-plaintext highlighter-rouge">pandas.Series</code>) em argumentos nomeados:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">sum3</span><span class="p">(</span><span class="n">a</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">b</span><span class="o">=</span><span class="mi">0</span><span class="p">,</span> <span class="n">c</span><span class="o">=</span><span class="mi">0</span><span class="p">):</span>
    <span class="k">return</span> <span class="n">a</span> <span class="o">+</span> <span class="n">b</span> <span class="o">+</span> <span class="n">c</span>
    
<span class="n">my_dict</span> <span class="o">=</span> <span class="p">{</span><span class="s">'a'</span><span class="p">:</span> <span class="mi">1</span><span class="p">,</span> <span class="s">'b'</span><span class="p">:</span> <span class="mi">2</span><span class="p">}</span>
<span class="n">s</span> <span class="o">=</span> <span class="n">sum3</span><span class="p">(</span><span class="o">**</span><span class="n">my_dict</span><span class="p">)</span> <span class="c1"># = sum3(a=1, b=2) = 3, já que c usa o valor padrão (0)
</span></code></pre></div></div>

<p>Isso não parece muito útil? Bom, eles são mais do que você pensa! Aqui vou
mostrar algumas construções legais usando <code class="language-plaintext highlighter-rouge">*</code> e <code class="language-plaintext highlighter-rouge">**</code>.</p>

<h3 id="objetivos">Objetivos</h3>

<ul>
  <li>
    <p>Mostrar alguns truques usando <code class="language-plaintext highlighter-rouge">*</code> que podem ser úteis quando estamos lidando
com listas, conjuntos, tuplas, dicionários e até strings;</p>
  </li>
  <li>
    <p>Comparar seu desempenho com outras construções funcionais ou imperativas,
medindo o tempo, olhando o bytecode e o olhando código-fonte do CPython.</p>
  </li>
</ul>

<h3 id="não-objetivos">Não-objetivos</h3>

<ul>
  <li>
    <p>Substituir <code class="language-plaintext highlighter-rouge">numpy</code>, <code class="language-plaintext highlighter-rouge">pandas</code>, <code class="language-plaintext highlighter-rouge">polars</code> ou qualquer outra biblioteca que
implementa estruturas de dados eficientes e suas operações;</p>
  </li>
  <li>
    <p>Criar uma “boa prática”, “padrão de código”, dizer “faça isso porque é
melhor”, etc. <strong>Encare com ceticismo tudo que você lê</strong>.</p>
  </li>
</ul>

<h2 id="1-converter-entre-para-listas-tuplas-e-conjuntos">1: Converter entre para listas, tuplas e conjuntos</h2>

<p>Eu mencionei sobre o <code class="language-plaintext highlighter-rouge">*</code> sendo usado como expansão de parâmetros em funções,
mas ele também pode ser usado para expandir elementos na sintaxe de declaração
de listas, tuplas e conjuntos, então, você pode usar ele facilmente para fazer
conversões entre esses tipos:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># convertendo listas, tuplas e conjuntos
</span><span class="n">my_list</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">]</span>
<span class="p">[</span><span class="o">*</span><span class="n">my_list</span><span class="p">]</span>  <span class="c1"># = [1, 2, 3]
</span><span class="p">{</span><span class="o">*</span><span class="n">my_list</span><span class="p">}</span>  <span class="c1"># = {1, 2, 3}
</span><span class="p">(</span><span class="o">*</span><span class="n">my_list</span><span class="p">,)</span> <span class="c1"># = (1, 2, 3), note a vírgula para garantir que é uma tupla!
</span></code></pre></div></div>

<h3 id="como-isso-se-compara-a-usar-um-construtor">Como isso se compara a usar um construtor?</h3>

<p>Talvez você está pensando que você pode fazer a mesma coisa usando <strong>construtores</strong>
de listas, tuplas e conjuntos, dessa forma:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1"># convertendo listas, tuplas e conjuntos
</span><span class="n">my_list</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">]</span>
<span class="nb">list</span><span class="p">(</span><span class="n">my_list</span><span class="p">)</span>  <span class="c1"># = [1, 2, 3]
</span><span class="nb">set</span><span class="p">(</span><span class="n">my_list</span><span class="p">)</span>   <span class="c1"># = {1, 2, 3}
</span><span class="nb">tuple</span><span class="p">(</span><span class="n">my_list</span><span class="p">)</span> <span class="c1"># = (1, 2, 3)
</span></code></pre></div></div>

<p>Sem problemas, use o que você preferir. Mas vamos analisar o que acontece
debaixo dos panos e comparar as duas abordagens no caso das listas. Podemos
conferir o bytecode usando o módulo <code class="language-plaintext highlighter-rouge">dis</code>:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">dis</span> <span class="kn">import</span> <span class="n">dis</span>

<span class="k">def</span> <span class="nf">f</span><span class="p">(</span><span class="n">x</span><span class="p">):</span>
    <span class="n">_</span> <span class="o">=</span> <span class="p">[</span><span class="o">*</span><span class="n">x</span><span class="p">]</span>
    <span class="n">_</span> <span class="o">=</span> <span class="nb">list</span><span class="p">(</span><span class="n">x</span><span class="p">)</span>

<span class="n">dis</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
</code></pre></div></div>

<p>Este é o resultado (estou executando Python 3.12):</p>

<div class="language-armasm highlighter-rouge"><div class="highlight"><pre class="highlight"><code>  <span class="err">2</span>           <span class="mi">2</span> <span class="nv">BUILD_LIST</span>               <span class="mi">0</span>
              <span class="err">4</span> <span class="nv">LOAD_FAST</span>                <span class="mi">0</span> <span class="o">(</span><span class="nv">x</span><span class="o">)</span>
              <span class="err">6</span> <span class="nv">LIST_EXTEND</span>              <span class="mi">1</span>
              <span class="err">8</span> <span class="nv">STORE_FAST</span>               <span class="mi">1</span> <span class="o">(</span><span class="nv">_</span><span class="o">)</span>

  <span class="err">3</span>          <span class="mi">10</span> <span class="nv">LOAD_GLOBAL</span>              <span class="mi">1</span> <span class="o">(</span><span class="nv">NULL</span> <span class="o">+</span> <span class="nv">list</span><span class="o">)</span>
             <span class="err">20</span> <span class="nv">LOAD_FAST</span>                <span class="mi">0</span> <span class="o">(</span><span class="nv">x</span><span class="o">)</span>
             <span class="err">22</span> <span class="nv">CALL</span>                     <span class="mi">1</span>
             <span class="err">30</span> <span class="nv">STORE_FAST</span>               <span class="mi">1</span> <span class="o">(</span><span class="nv">_</span><span class="o">)</span>
             <span class="err">32</span> <span class="nv">RETURN_CONST</span>             <span class="mi">0</span> <span class="o">(</span><span class="nv">None</span><span class="o">)</span>
</code></pre></div></div>

<p>A primeira metade do bytecode se refere a <code class="language-plaintext highlighter-rouge">[*x]</code> e a segunda a <code class="language-plaintext highlighter-rouge">list(x)</code>.</p>

<p>Na primeira metade (<code class="language-plaintext highlighter-rouge">[*x]</code>):</p>

<ol>
  <li>cria uma lista vazia (<code class="language-plaintext highlighter-rouge">BUILD_LIST 0</code>) e manda para o topo da pilha de execução;</li>
  <li>carrega <code class="language-plaintext highlighter-rouge">x</code> no topo da pilha (<code class="language-plaintext highlighter-rouge">LOAD_FAST 0</code>);</li>
  <li>estende a lista vazia (<code class="language-plaintext highlighter-rouge">LIST_EXTEND 1</code>) com o iterável <code class="language-plaintext highlighter-rouge">x</code>. Equivalente a <code class="language-plaintext highlighter-rouge">list.extend(x)</code>;</li>
  <li>guarda o resultado na variável <code class="language-plaintext highlighter-rouge">_</code> (<code class="language-plaintext highlighter-rouge">STORE_FAST 1</code>).</li>
</ol>

<p>Na segunda metade (<code class="language-plaintext highlighter-rouge">list(x)</code>):</p>

<ol>
  <li>carrega o construtor <code class="language-plaintext highlighter-rouge">list</code> na pilha (<code class="language-plaintext highlighter-rouge">LOAD_GLOBAL 1</code>);</li>
  <li>carrega <code class="language-plaintext highlighter-rouge">x</code> na pilha (<code class="language-plaintext highlighter-rouge">LOAD_FAST 0</code>)</li>
  <li>chama o construtor <code class="language-plaintext highlighter-rouge">list</code> passando <code class="language-plaintext highlighter-rouge">x</code>como argumento <code class="language-plaintext highlighter-rouge">list(x)</code> (<code class="language-plaintext highlighter-rouge">CALL 1</code>)</li>
  <li>guarda o resultado na variável <code class="language-plaintext highlighter-rouge">_</code> (<code class="language-plaintext highlighter-rouge">STORE_FAST 1</code>).</li>
</ol>

<blockquote>
  <p>Nota: <code class="language-plaintext highlighter-rouge">RETURN_CONST 0</code> faz a função devolver <code class="language-plaintext highlighter-rouge">None</code>, já que esse é o
comportamento padrão em Python para funções que não têm valor de retorno</p>
</blockquote>

<p>Então, a principal diferença entre elas é que a primeira <strong>cria uma lista
vazia</strong> e depois a estende, enquanto que a segunda chama o construtor
<code class="language-plaintext highlighter-rouge">list</code>. Qual é melhor? Vamos ver o código fonte do CPython!</p>

<ul>
  <li>
    <p>a implementação da instrução <code class="language-plaintext highlighter-rouge">BUILD_LIST</code> 
(<a href="https://github.com/python/cpython/blob/3.12/Python/bytecodes.c#L1501-L1504">aqui</a>)
chama a função <code class="language-plaintext highlighter-rouge">_PyList_FromArraySteal</code>(<a href="https://github.com/python/cpython/blob/3.12/Objects/listobject.c#L2566-L2579">esta</a>).
Quando o tamanho da lista é 0, ela somente chama <code class="language-plaintext highlighter-rouge">PyList_New</code>. Ela é, basicamente
alocação de memória;</p>
  </li>
  <li>
    <p>a implementação da instrução <code class="language-plaintext highlighter-rouge">LIST_EXTEND</code> (<a href="https://github.com/python/cpython/blob/3.12/Python/bytecodes.c#L1506-L1522">aqui</a>)
chama a função <code class="language-plaintext highlighter-rouge">_PyListExtend</code>
(<a href="https://github.com/python/cpython/blob/3.12/Objects/listobject.c#L979-L995">esta</a>),
que é só uma casca para <code class="language-plaintext highlighter-rouge">list_extend</code>, que vai estender a lista vazia com os 
valores  de <code class="language-plaintext highlighter-rouge">x</code>;</p>
  </li>
  <li>
    <p>o inicializador de <code class="language-plaintext highlighter-rouge">list</code>
(<a href="https://github.com/python/cpython/blob/3.12/Objects/listobject.c#L2784-L2805">aqui</a>)
também vai chamar <code class="language-plaintext highlighter-rouge">list_extend</code>, estendendo a lista vazia recém criada com
valores de <code class="language-plaintext highlighter-rouge">x</code>.</p>
  </li>
</ul>

<p>Dessa forma, ambas fazem a mesma coisa!</p>

<h2 id="2-criar-listas-a-partir-de-geradores">2: Criar listas a partir de geradores</h2>

<p>Como eu disse antes, <code class="language-plaintext highlighter-rouge">*</code> pode expandir qualquer iterável, então, você pode
usá-lo com qualquer gerador. Por exemplo, o clássico <code class="language-plaintext highlighter-rouge">range</code>:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">[</span><span class="o">*</span><span class="nb">range</span><span class="p">(</span><span class="mi">5</span><span class="p">)]</span> <span class="c1"># = [0, 1, 2, 3, 4]
</span></code></pre></div></div>

<p>Mas você também pode usar ele com geradores mais interessantes. Eu recomendo
fortemente que você leia sobre o módulo <em>built-in</em>
<a href="https://docs.python.org/pt-br/3/library/itertools.html">itertools</a>. Ele
disponibiliza vários iteradores interessantes que você também pode usar
aqui. Por exemplo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">functools</span> <span class="kn">import</span> <span class="n">permutations</span><span class="p">,</span> <span class="n">pairwise</span>

<span class="c1"># Permutaç~oes
</span><span class="p">[</span><span class="o">*</span><span class="n">permutations</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">])]</span> <span class="c1"># = [(1, 2, 3), (1, 3, 2), (2, 1, 3), (2, 3, 1), (3, 1, 2), (3, 2, 1)]
</span>
<span class="c1"># Mapeia cada elemento com o seu próximo
</span><span class="p">[</span><span class="o">*</span><span class="n">pairwise</span><span class="p">([</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">4</span><span class="p">])]</span>  <span class="c1"># = [(1, 2), (2, 3), (3, 4)]
</span></code></pre></div></div>

<p>A mesma coisa pode ser feita para <strong>tuplas</strong> e <strong>conjuntos</strong>, da mesma forma que
antes! E, da mesma forma que antes, a gente pode usar os construtores <code class="language-plaintext highlighter-rouge">list</code>,
<code class="language-plaintext highlighter-rouge">tuple</code> e <code class="language-plaintext highlighter-rouge">set</code> no lugar da sintaxe correspondente (e eles vão fazer basicamente
a mesma coisa debaixo dos panos, da mesma forma que o truque anterior).</p>

<h2 id="3-concatenar-listas-tuplas-e-conjuntos">3: Concatenar listas, tuplas e conjuntos</h2>

<p>Como <code class="language-plaintext highlighter-rouge">*</code> pode ser usado em declaração de listas, você também pode usar para
juntar uma ou mais delas:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code>
<span class="n">list_1</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">]</span>
<span class="n">list_2</span> <span class="o">=</span> <span class="p">[</span><span class="mi">4</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">6</span><span class="p">]</span>

<span class="p">[</span><span class="o">*</span><span class="n">list_1</span><span class="p">,</span> <span class="o">*</span><span class="n">list_2</span><span class="p">]</span> <span class="c1"># = [1, 2, 3, 4, 5, 6]
</span>
</code></pre></div></div>

<p>Você ainda pode misturar listas (e outros iteráveis) e elementos soltos:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">list_1</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">]</span>
<span class="n">list_2</span> <span class="o">=</span> <span class="p">[</span><span class="mi">4</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">6</span><span class="p">]</span>

<span class="p">[</span><span class="o">*</span><span class="n">list_1</span><span class="p">,</span> <span class="mi">11</span><span class="p">,</span> <span class="o">*</span><span class="n">list_2</span><span class="p">,</span> <span class="mi">12</span><span class="p">,</span> <span class="mi">13</span><span class="p">,</span> <span class="o">*</span><span class="nb">range</span><span class="p">(</span><span class="mi">3</span><span class="p">)]</span> <span class="c1"># = [1, 2, 3, 11, 4, 5, 6, 12, 13, 0, 1, 2]
</span></code></pre></div></div>

<p>Da mesma forma que os truques anteriores, isso pode usado para criar tuplas e
conjuntos!</p>

<h3 id="olhando-o-bytecode-de-novo">Olhando o bytecode de novo</h3>

<p>Ok, mas o que acontece internamente? Vamos usar <code class="language-plaintext highlighter-rouge">dis</code> novamente aqui:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">f</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">,</span> <span class="n">c</span><span class="p">):</span>
    <span class="n">_</span> <span class="o">=</span> <span class="p">[</span><span class="o">*</span><span class="n">a</span><span class="p">,</span> <span class="o">*</span><span class="n">b</span><span class="p">,</span> <span class="o">*</span><span class="n">c</span><span class="p">]</span>

<span class="n">dis</span><span class="p">(</span><span class="n">f</span><span class="p">)</span>
</code></pre></div></div>

<p>E esse é o resultado:</p>

<div class="language-armasm highlighter-rouge"><div class="highlight"><pre class="highlight"><code>  <span class="err">2</span>           <span class="mi">2</span> <span class="nv">BUILD_LIST</span>               <span class="mi">0</span>
              <span class="err">4</span> <span class="nv">LOAD_FAST</span>                <span class="mi">0</span> <span class="o">(</span><span class="nv">a</span><span class="o">)</span>
              <span class="err">6</span> <span class="nv">LIST_EXTEND</span>              <span class="mi">1</span>
              <span class="err">8</span> <span class="nv">LOAD_FAST</span>                <span class="mi">1</span> <span class="o">(</span><span class="nv">b</span><span class="o">)</span>
             <span class="err">10</span> <span class="nv">LIST_EXTEND</span>              <span class="mi">1</span>
             <span class="err">12</span> <span class="nv">LOAD_FAST</span>                <span class="mi">2</span> <span class="o">(</span><span class="nv">c</span><span class="o">)</span>
             <span class="err">14</span> <span class="nv">LIST_EXTEND</span>              <span class="mi">1</span>
             <span class="err">16</span> <span class="nv">STORE_FAST</span>               <span class="mi">3</span> <span class="o">(</span><span class="nv">_</span><span class="o">)</span>
             <span class="err">18</span> <span class="nv">RETURN_CONST</span>             <span class="mi">0</span> <span class="o">(</span><span class="nv">None</span><span class="o">)</span>

</code></pre></div></div>

<p>Bem parecido com a saída do truque 1, mas aqui <code class="language-plaintext highlighter-rouge">LOAD_FAST</code> e <code class="language-plaintext highlighter-rouge">LIST_EXTEND</code> são
chamados 3 vezes em vez de apenas 1 (como esperado, já que estamos concatenando
3 listas).</p>

<h2 id="4-concatenar-dicionários">4: Concatenar dicionários</h2>

<p>Da mesma forma, você pode concatenar dois ou mais dicionários, porém usando <code class="language-plaintext highlighter-rouge">**</code>
    já que estamos lidando com mapeamentos em vez de um iterador:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">d1</span> <span class="o">=</span> <span class="p">{</span><span class="s">'I'</span><span class="p">:</span> <span class="mi">1</span><span class="p">,</span> <span class="s">'V'</span><span class="p">:</span> <span class="mi">5</span><span class="p">,</span> <span class="s">'X'</span><span class="p">:</span> <span class="mi">10</span><span class="p">}</span>
<span class="n">d2</span> <span class="o">=</span> <span class="p">{</span><span class="s">'L'</span><span class="p">:</span> <span class="mi">50</span><span class="p">,</span> <span class="s">'C'</span><span class="p">:</span> <span class="mi">100</span><span class="p">}</span>

<span class="p">{</span><span class="o">**</span><span class="n">d1</span><span class="p">,</span> <span class="o">**</span><span class="n">d2</span><span class="p">}</span> <span class="c1"># = {'I': 1, 'V': 5, 'X': 10, 'L': 50, 'C': 100}
</span>
</code></pre></div></div>

<p>Repare que você precisa usar <code class="language-plaintext highlighter-rouge">**</code> aqui. Se você usar <code class="language-plaintext highlighter-rouge">*</code>, ele vai expandir
apenas as <strong>chaves</strong> do dicionário, e então vai construir um <strong>conjunto</strong> em vez
de um dicionário:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="o">*</span><span class="n">d1</span><span class="p">,</span> <span class="o">*</span><span class="n">d2</span><span class="p">}</span> <span class="c1"># = {'C', 'I', 'L', 'V', 'X'}
</span></code></pre></div></div>

<h3 id="comentário-sobre-pep-584">Comentário sobre PEP 584</h3>

<p>Essa construção era mais útil antes da
<a href="https://peps.python.org/pep-0584/">PEP 584</a> em Python 3.9.
Ela introduziu o operador de união (<code class="language-plaintext highlighter-rouge">|</code>) para <strong>dicionários</strong> da mesma forma
como já havia para <strong>conjuntos</strong>. Hoje em dia você pode juntar dois dicionários
da seguinte forma:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">d1</span> <span class="o">|</span> <span class="n">d2</span> <span class="c1"># = {'I': 1, 'V': 5, 'X': 10, 'L': 50, 'C': 100}
</span></code></pre></div></div>

<p>Isso não significa que este truque se tornou inútil. Você pode usá-la para
criar um novo dicionário a partir de outros dicionários e de novas chaves, por
exemplo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="o">**</span><span class="n">d1</span><span class="p">,</span> <span class="o">**</span><span class="n">d2</span><span class="p">,</span> <span class="s">'D'</span><span class="p">:</span> <span class="mi">500</span><span class="p">,</span> <span class="s">'M'</span><span class="p">:</span> <span class="mi">1000</span><span class="p">}</span> <span class="c1"># = {'I': 1, 'V': 5, 'X': 10, 'L': 50, 'C':100, 'D': 500, 'M': 1000}
</span></code></pre></div></div>

<h2 id="5-tuple-comprehensions">5: Tuple comprehensions</h2>

<p>Em Python nós temos <strong>list comprehensions</strong>, <strong>dictionary comprehensions</strong> e <strong>set
comprehensions</strong>. Mas não temos <strong>tuple comprehensions</strong>:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">[</span><span class="mi">2</span> <span class="o">*</span> <span class="n">x</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)]</span>     <span class="c1"># list comprehension
</span><span class="p">{</span><span class="mi">2</span> <span class="o">*</span> <span class="n">x</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)}</span>     <span class="c1"># set comprehension
</span><span class="p">{</span><span class="n">x</span><span class="p">:</span> <span class="mi">2</span> <span class="o">*</span> <span class="n">x</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)}</span>  <span class="c1"># dict comprehension
</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">x</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">))</span>     <span class="c1"># tuple comp... não, é um gerador!
</span></code></pre></div></div>

<p>Mas a gente meio que pode ter uma “tuple comprhension” convertendo um gerador
para uma tupla usando o truque 2:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">(</span><span class="o">*</span><span class="p">(</span><span class="mi">2</span> <span class="o">*</span> <span class="n">x</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)),)</span> <span class="c1"># "tuple comprehension"
</span></code></pre></div></div>

<blockquote>
  <p>Note: se isso parece útil para você, então talvez tuplas não seja o que você
está precisando! Tuplas são mais do que listas imutáveis: tipicamente, você
usa tuplas quando cada posição tem um significado, como em um par ordenado.
Como sugestão, leia a seção “Tuplas não são apenas listas imutáveis”
no livro <strong>Python Fluente</strong> de Luciano Ramalho.</p>
</blockquote>

<h2 id="6-imprimir-listas-de-forma-bonita">6: Imprimir listas de forma bonita</h2>

<p>Às vezes você quer imprimir uma lista, mas em uma forma mais legível para humano
do que a representação <code class="language-plaintext highlighter-rouge">[foo, bar]</code>. Você pode, por exemplo, usar <code class="language-plaintext highlighter-rouge">str.join</code>:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">my_list</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">]</span>
<span class="k">print</span><span class="p">(</span><span class="s">' -&gt; '</span><span class="p">.</span><span class="n">join</span><span class="p">([</span><span class="nb">str</span><span class="p">(</span><span class="n">x</span><span class="p">)</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">my_list</span><span class="p">]))</span> <span class="c1"># 1 -&gt; 2 -&gt; 3
</span></code></pre></div></div>

<p>Mas existe uma solução ainda mais limpa: você pode usar <code class="language-plaintext highlighter-rouge">*</code> para passar cada
elemento da lista como um parâmetro. Depois você pode especificar qual separador
você quer usar (por padrão, espaço):</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">print</span><span class="p">(</span><span class="o">*</span><span class="n">my_list</span><span class="p">)</span>             <span class="c1"># 1 2 3
</span><span class="k">print</span><span class="p">(</span><span class="o">*</span><span class="n">my_list</span><span class="p">,</span> <span class="n">sep</span><span class="o">=</span><span class="s">' -&gt; '</span><span class="p">)</span> <span class="c1"># 1 -&gt; 2 -&gt; 3
</span></code></pre></div></div>

<p>Muito mais limpo. Outro exemplo, um código simples para gerar um arquivo CSV
em apenas 3 linhas:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">data</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">),</span>
    <span class="p">(</span><span class="mi">4</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">6</span><span class="p">),</span>
    <span class="p">(</span><span class="mi">7</span><span class="p">,</span> <span class="mi">8</span><span class="p">,</span> <span class="mi">9</span><span class="p">)</span>
<span class="p">]</span>

<span class="k">with</span> <span class="nb">open</span><span class="p">(</span><span class="s">'output.csv'</span><span class="p">,</span> <span class="s">'w'</span><span class="p">)</span> <span class="k">as</span> <span class="n">f</span><span class="p">:</span>
    <span class="k">for</span> <span class="n">row</span> <span class="ow">in</span> <span class="n">data</span><span class="p">:</span>
        <span class="k">print</span><span class="p">(</span><span class="o">*</span><span class="n">row</span><span class="p">,</span> <span class="n">sep</span><span class="o">=</span><span class="s">','</span><span class="p">,</span> <span class="nb">file</span><span class="o">=</span><span class="n">f</span><span class="p">)</span>
</code></pre></div></div>

<h2 id="7-transpor-matrizes">7: Transpor matrizes</h2>

<p>A função <code class="language-plaintext highlighter-rouge">zip</code> itera simultaneamente sobre dois iteradores, por exemplo:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">for</span> <span class="n">pair</span> <span class="ow">in</span> <span class="nb">zip</span><span class="p">(</span><span class="nb">range</span><span class="p">(</span><span class="mi">3</span><span class="p">),</span> <span class="nb">range</span><span class="p">(</span><span class="mi">3</span><span class="p">,</span> <span class="mi">6</span><span class="p">)):</span>
    <span class="k">print</span><span class="p">(</span><span class="n">pair</span><span class="p">)</span>   <span class="c1"># (0, 3) (1, 4) (2, 5)
</span></code></pre></div></div>

<p>Dessa forma, você pode usar <code class="language-plaintext highlighter-rouge">*</code> para iterar sobre elementos de todas as linhas
ao mesmo tempo usando <code class="language-plaintext highlighter-rouge">zip</code>, ou em outras palavras, iterar sobre as colunas:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">my_matrix</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">(</span><span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">),</span>
    <span class="p">(</span><span class="mi">4</span><span class="p">,</span> <span class="mi">5</span><span class="p">,</span> <span class="mi">6</span><span class="p">),</span>
    <span class="p">(</span><span class="mi">7</span><span class="p">,</span> <span class="mi">8</span><span class="p">,</span> <span class="mi">9</span><span class="p">)</span>
<span class="p">]</span>

<span class="k">for</span> <span class="n">column</span> <span class="ow">in</span> <span class="nb">zip</span><span class="p">(</span><span class="o">*</span><span class="n">my_matrix</span><span class="p">):</span>
    <span class="k">print</span><span class="p">(</span><span class="n">column</span><span class="p">)</span>   <span class="c1"># (1, 4, 7) (2, 5, 8) (3, 6, 9)
</span></code></pre></div></div>

<p>Se você criar uma lista de colunas, então você terá uma matriz transposta! Você
só precisa converter <code class="language-plaintext highlighter-rouge">zip(*my_matrix)</code> para uma lista usando a mesma sintaxe de
antes:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">[</span><span class="o">*</span><span class="nb">zip</span><span class="p">(</span><span class="o">*</span><span class="n">my_matrix</span><span class="p">)]</span> <span class="c1"># [(1, 4, 7), (2, 5, 8), (3, 6, 9)]
</span></code></pre></div></div>

<h3 id="e-o-numpy">E o NumPy?</h3>

<p>O NumPy é incrível, é claro! Você pode transpor uma matriz usando <code class="language-plaintext highlighter-rouge">my_matrix.T</code>, 
e isso é <code class="language-plaintext highlighter-rouge">O(1)</code>. Mas você precisará:</p>

<ol>
  <li>importar NumPy</li>
  <li>usar <code class="language-plaintext highlighter-rouge">numpy.array</code> ou similar</li>
</ol>

<p>Se você já está usando o NumPy e você precisa transpor uma matriz, vá em frente,
use <code class="language-plaintext highlighter-rouge">.T</code>. Mas se você vai usar NumPy apenas para transpor uma matriz, talvez ele
não seja a melhor opção. Importar o NumPy e converter uma matriz de listas do
Python para NumPy custa tempo.</p>

<p>Aqui vai um teste simples (tente rodá-lo em sua máquina)</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">time</span> <span class="kn">import</span> <span class="n">time</span>

<span class="n">a</span> <span class="o">=</span> <span class="n">time</span><span class="p">();</span> <span class="kn">import</span> <span class="nn">numpy</span> <span class="k">as</span> <span class="n">np</span><span class="p">;</span> <span class="n">b</span> <span class="o">=</span> <span class="n">time</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="s">'Numpy loading time: '</span><span class="p">,</span> <span class="n">b</span> <span class="o">-</span> <span class="n">a</span><span class="p">)</span>

<span class="n">my_matrix</span> <span class="o">=</span> <span class="p">[[</span><span class="n">i</span> <span class="o">*</span> <span class="mi">10</span> <span class="o">+</span> <span class="n">j</span> <span class="k">for</span> <span class="n">j</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)]</span> <span class="k">for</span> <span class="n">i</span> <span class="ow">in</span> <span class="nb">range</span><span class="p">(</span><span class="mi">10</span><span class="p">)]</span>

<span class="n">a</span> <span class="o">=</span> <span class="n">time</span><span class="p">();</span> <span class="n">transposed</span> <span class="o">=</span> <span class="p">[</span><span class="o">*</span><span class="nb">zip</span><span class="p">(</span><span class="o">*</span><span class="n">my_matrix</span><span class="p">)];</span> <span class="n">b</span> <span class="o">=</span> <span class="n">time</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="s">'zip time: '</span><span class="p">,</span> <span class="n">b</span> <span class="o">-</span> <span class="n">a</span><span class="p">)</span>

<span class="n">a</span> <span class="o">=</span> <span class="n">time</span><span class="p">();</span> <span class="n">transposed</span> <span class="o">=</span> <span class="n">np</span><span class="p">.</span><span class="n">array</span><span class="p">(</span><span class="n">my_matrix</span><span class="p">).</span><span class="n">T</span><span class="p">;</span> <span class="n">b</span> <span class="o">=</span> <span class="n">time</span><span class="p">()</span>
<span class="k">print</span><span class="p">(</span><span class="s">'numpy time: '</span><span class="p">,</span> <span class="n">b</span> <span class="o">-</span> <span class="n">a</span><span class="p">)</span>
</code></pre></div></div>

<p>Na minha máquina (um velho i5 de segunda geração), essa é a saída:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>Numpy loading time:  0.10406970977783203
zip time:  7.62939453125e-06
numpy time:  1.6450881958007812e-05
</code></pre></div></div>

<p>Repare que ele tomou <strong>2x</strong> mais tempo para <strong>criar</strong> um <code class="language-plaintext highlighter-rouge">np.array</code> a partir de
uma matriz existente e o transpor, e tomou mais de <strong>10000x</strong> o tempo para
importar o NumPy! E essa é uma matriz relativamente grande (10x10)!</p>

<blockquote>
  <p>“Não use um canhão para matar um mosquito” - Confúcio</p>
</blockquote>

<h2 id="8-selecionar-elementos-sem-repetição">8: Selecionar elementos sem repetição</h2>

<p>Uma das diferenças entre listas e conjuntos é que conjuntos não podem conter o
mesmo elemento duas vezes. Então, se nós queremos uma lista com elementos
únicos, nós podemos convertê-la para um conjunto e convertê-la de volta para uma
lista:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nb">list</span> <span class="o">=</span> <span class="p">[</span><span class="mi">1</span><span class="p">,</span> <span class="mi">1</span><span class="p">,</span> <span class="mi">2</span><span class="p">,</span> <span class="mi">3</span><span class="p">,</span> <span class="mi">5</span><span class="p">]</span>
<span class="p">[</span><span class="o">*</span><span class="p">{</span><span class="o">*</span><span class="nb">list</span><span class="p">}]</span> <span class="c1"># [1, 2, 3, 5]
</span></code></pre></div></div>

<p>Note que conjuntos não têm ordem. Mas você pode usar um <code class="language-plaintext highlighter-rouge">collections.Counter</code>
aqui e ele irá preservar a primeira ocorrência (caso precise):</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="kn">from</span> <span class="nn">collections</span> <span class="kn">import</span> <span class="n">Counter</span>

<span class="p">[</span><span class="o">*</span><span class="n">Counter</span><span class="p">(</span><span class="nb">list</span><span class="p">)]</span> <span class="c1"># [1, 2, 3, 5]
</span>
<span class="c1"># or
</span>
<span class="n">Counter</span><span class="p">(</span><span class="nb">list</span><span class="p">).</span><span class="n">elements</span><span class="p">()</span>
</code></pre></div></div>

<blockquote>
  <p>Da mesma forma que antes, você poderia usar <code class="language-plaintext highlighter-rouge">numpy.unique</code>, mas lembre-se de Confúcio!</p>
</blockquote>

<h2 id="9-criar-uma-lista-com-substitutos-para-elementos-nulos">9: Criar uma lista com substitutos para elementos nulos</h2>

<p>Olhe esta lista com dados sobre super-herois (seus nomes, seus nomes reais e
seus poderes):</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">heroes</span> <span class="o">=</span> <span class="p">[</span>
    <span class="p">{</span>
        <span class="s">'name'</span><span class="p">:</span> <span class="s">'spider-man'</span><span class="p">,</span>
        <span class="s">'real name'</span><span class="p">:</span> <span class="s">'peter parker'</span><span class="p">,</span>
        <span class="s">'powers'</span><span class="p">:</span> <span class="p">[</span><span class="s">'wall crawling'</span><span class="p">,</span> <span class="s">'webbing'</span><span class="p">],</span>
    <span class="p">},</span>
    
    <span class="p">{</span>
        <span class="s">'name'</span><span class="p">:</span> <span class="s">'batman'</span><span class="p">,</span>
        <span class="s">'real name'</span><span class="p">:</span> <span class="s">'bruce wayne'</span><span class="p">,</span>
        <span class="s">'powers'</span><span class="p">:</span> <span class="p">[]</span>
    <span class="p">}</span>
<span class="p">]</span>
</code></pre></div></div>

<p>Se você quer criar uma representação legível para humanos de cada um desses
herois, você poderia, por exemplo, fazer isso:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">hero_string</span><span class="p">(</span><span class="n">hero</span><span class="p">):</span>
    <span class="n">s</span> <span class="o">=</span> <span class="s">''</span>
    <span class="n">s</span> <span class="o">+=</span> <span class="sa">f</span><span class="s">'name: </span><span class="si">{</span><span class="n">hero</span><span class="p">[</span><span class="s">'name'</span><span class="p">]</span><span class="si">}</span><span class="se">\n</span><span class="s">'</span>
    <span class="n">s</span> <span class="o">+=</span> <span class="sa">f</span><span class="s">'real name: </span><span class="si">{</span><span class="n">hero</span><span class="p">[</span><span class="s">'real name'</span><span class="p">]</span><span class="si">}</span><span class="se">\n</span><span class="s">'</span>

    <span class="k">if</span> <span class="n">hero</span><span class="p">[</span><span class="s">'powers'</span><span class="p">]:</span>
        <span class="k">for</span> <span class="n">power</span> <span class="ow">in</span> <span class="n">hero</span><span class="p">[</span><span class="s">'powers'</span><span class="p">]:</span>
            <span class="n">s</span> <span class="o">+=</span> <span class="sa">f</span><span class="s">'power: </span><span class="si">{</span><span class="n">power</span><span class="si">}</span><span class="se">\n</span><span class="s">'</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">s</span> <span class="o">+=</span> <span class="s">'No powers!'</span>
    <span class="k">return</span> <span class="n">s</span>
</code></pre></div></div>

<p>Repare que para o Spider-Man ele vai mostrar seus poderes e para o Batman ele
vai mostrar “No powers!”.</p>

<p>Ok, mas somar strings não é tão eficiente quanto escrever <code class="language-plaintext highlighter-rouge">str.join</code>. Uma
segunda solução seria:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">hero_string</span><span class="p">(</span><span class="n">hero</span><span class="p">):</span>
    <span class="n">names</span> <span class="o">=</span> <span class="s">'</span><span class="se">\n</span><span class="s">'</span><span class="p">.</span><span class="n">join</span><span class="p">([</span>
        <span class="sa">f</span><span class="s">'name: </span><span class="si">{</span><span class="n">hero</span><span class="p">[</span><span class="s">"name"</span><span class="p">]</span><span class="si">}</span><span class="s">'</span><span class="p">,</span>
        <span class="sa">f</span><span class="s">'real name: </span><span class="si">{</span><span class="n">hero</span><span class="p">[</span><span class="s">"real name"</span><span class="p">]</span><span class="si">}</span><span class="s">'</span>
    <span class="p">])</span>

    <span class="k">if</span> <span class="n">hero</span><span class="p">[</span><span class="s">'powers'</span><span class="p">]:</span>
        <span class="n">powers</span> <span class="o">=</span> <span class="s">'</span><span class="se">\n</span><span class="s">'</span><span class="p">.</span><span class="n">join</span><span class="p">(</span><span class="sa">f</span><span class="s">'power: </span><span class="si">{</span><span class="n">power</span><span class="si">}</span><span class="s">'</span> <span class="k">for</span> <span class="n">power</span> <span class="ow">in</span> <span class="n">hero</span><span class="p">[</span><span class="s">'powers'</span><span class="p">])</span>
    <span class="k">else</span><span class="p">:</span>
        <span class="n">powers</span> <span class="o">=</span> <span class="s">'No powers!'</span>

    <span class="k">return</span> <span class="s">'</span><span class="se">\n</span><span class="s">'</span><span class="p">.</span><span class="n">join</span><span class="p">([</span><span class="n">names</span><span class="p">,</span> <span class="n">powers</span><span class="p">])</span>
</code></pre></div></div>

<p>Bem, nós não conseguimos escrever com só um <code class="language-plaintext highlighter-rouge">'\n'.join</code> já que precisamos tratar
o caso especial do Batman… Mas nosso amigo <code class="language-plaintext highlighter-rouge">*</code> pode nos ajudar aqui:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="k">def</span> <span class="nf">hero_string</span><span class="p">(</span><span class="n">hero</span><span class="p">):</span>
    <span class="n">powers</span> <span class="o">=</span> <span class="p">[</span><span class="sa">f</span><span class="s">'power: </span><span class="si">{</span><span class="n">power</span><span class="si">}</span><span class="s">'</span> <span class="k">for</span> <span class="n">power</span> <span class="ow">in</span> <span class="n">hero</span><span class="p">[</span><span class="s">'powers'</span><span class="p">]]</span> <span class="ow">or</span> <span class="p">[</span><span class="s">'No powers!'</span><span class="p">]</span>

    <span class="k">return</span> <span class="s">'</span><span class="se">\n</span><span class="s">'</span><span class="p">.</span><span class="n">join</span><span class="p">([</span>
        <span class="sa">f</span><span class="s">'name: </span><span class="si">{</span><span class="n">hero</span><span class="p">[</span><span class="s">"name"</span><span class="p">]</span><span class="si">}</span><span class="s">'</span><span class="p">,</span>
        <span class="sa">f</span><span class="s">'real name: </span><span class="si">{</span><span class="n">hero</span><span class="p">[</span><span class="s">"real name"</span><span class="p">]</span><span class="si">}</span><span class="s">'</span><span class="p">,</span>
        <span class="o">*</span><span class="n">powers</span>
    <span class="p">])</span>
</code></pre></div></div>

<p>Dessa forma, <code class="language-plaintext highlighter-rouge">powers</code> vai ser uma lista de linhas contendo os poderes ou
contendo “No Powers!” caso o heroi não tenha poderes. Então, ela será expandida
depois com <code class="language-plaintext highlighter-rouge">join</code>.</p>

<h2 id="10-conferir-se-todos-os-elementos-estão-em-um-conjunto">10: Conferir se todos os elementos estão em um conjunto</h2>

<p>Este é meu preferido. Se você quer conferir se todos os elementos de uma lista
estão contidos em outra lista, você pode fazer isso (quando os operandos são
conjuntos, o operador <code class="language-plaintext highlighter-rouge">&lt;=</code> significa “é um subconjunto de”):</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">a</span> <span class="o">=</span> <span class="p">[</span><span class="mi">11</span><span class="p">,</span> <span class="mi">22</span><span class="p">,</span> <span class="mi">33</span><span class="p">]</span>
<span class="n">b</span> <span class="o">=</span> <span class="p">[</span><span class="mi">11</span><span class="p">,</span> <span class="mi">22</span><span class="p">,</span> <span class="o">-</span><span class="mi">1</span><span class="p">]</span>
<span class="n">c</span> <span class="o">=</span> <span class="p">[</span><span class="mi">11</span><span class="p">]</span>
<span class="n">d</span> <span class="o">=</span> <span class="p">[</span><span class="mi">11</span><span class="p">,</span> <span class="mi">22</span><span class="p">,</span> <span class="mi">33</span><span class="p">,</span> <span class="mi">44</span><span class="p">]</span>

<span class="p">{</span><span class="o">*</span><span class="n">a</span><span class="p">}</span> <span class="o">&lt;=</span> <span class="p">{</span><span class="o">*</span><span class="n">d</span><span class="p">}</span> <span class="c1"># true
</span><span class="p">{</span><span class="o">*</span><span class="n">b</span><span class="p">}</span> <span class="o">&lt;=</span> <span class="p">{</span><span class="o">*</span><span class="n">d</span><span class="p">}</span> <span class="c1"># false
</span><span class="p">{</span><span class="o">*</span><span class="n">c</span><span class="p">}</span> <span class="o">&lt;=</span> <span class="p">{</span><span class="o">*</span><span class="n">d</span><span class="p">}</span> <span class="c1"># false
</span></code></pre></div></div>

<p>Você também pode usar <code class="language-plaintext highlighter-rouge">==</code> para conferir se os elementos de duas são os mesmos
(mesmo que sua ordem seja diferente ou que eles tenham elementos repetidos):</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="o">*</span><span class="n">a</span><span class="p">}</span> <span class="o">==</span> <span class="p">{</span><span class="o">*</span><span class="n">d</span><span class="p">}</span>
</code></pre></div></div>

<p>Você também pode usar isso com strings. Este exemplo checa se uma string contém
apenas vogais:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="p">{</span><span class="o">*</span><span class="n">my_string</span><span class="p">}</span> <span class="o">&lt;=</span> <span class="p">{</span><span class="o">*</span><span class="s">'aeiou'</span><span class="p">}</span>
</code></pre></div></div>

<h3 id="complexidade">Complexidade</h3>

<p>Uma abordagem mais imperativa sobre isso seria:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">result</span> <span class="o">=</span> <span class="bp">True</span>

<span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">a</span><span class="p">:</span>               <span class="c1"># O(len(a))
</span>   <span class="k">if</span> <span class="n">x</span> <span class="ow">not</span> <span class="ow">in</span> <span class="n">d</span><span class="p">:</span>         <span class="c1"># O(len(d))
</span>       <span class="n">result</span> <span class="o">=</span> <span class="bp">False</span>
       <span class="k">break</span>
</code></pre></div></div>

<p>A operação <code class="language-plaintext highlighter-rouge">in</code> sobre listas é <code class="language-plaintext highlighter-rouge">O(n)</code>, então, essa abordagem <strong>imperativa</strong> é 
<code class="language-plaintext highlighter-rouge">O(len(a) * len(d))</code> no pior caso e <code class="language-plaintext highlighter-rouge">O(len(d))</code> no melhor caso.</p>

<p>De volta à nossa solução anterior, a criação de um conjunto é <code class="language-plaintext highlighter-rouge">O(n)</code> e a operaçao
<code class="language-plaintext highlighter-rouge">set1 &lt;= set2</code> é <code class="language-plaintext highlighter-rouge">O(len(set1))</code>, então, nossa solução é <code class="language-plaintext highlighter-rouge">O(len(a) + len(b))</code> no
pior caso. Muito melhor, sem dúvida. Mas no melhor caso ela também vai ser
<code class="language-plaintext highlighter-rouge">O(len(a) + len(b))</code>, já que ela precisa iterar sobre <em>todos</em> os elementos de
<code class="language-plaintext highlighter-rouge">a</code> e <code class="language-plaintext highlighter-rouge">d</code> mesmo que essas listas sejam completamente diferentes! Então, a gente
pode <strong>melhorar nossa solução</strong>, pelo menos em termos de complexidade.</p>

<p>A nossa solução resolve isso, mas claro que ela não é tão elegante:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">set_d</span> <span class="o">=</span> <span class="p">{</span><span class="o">*</span><span class="n">d</span><span class="p">}</span>
<span class="nb">all</span><span class="p">(</span><span class="n">x</span> <span class="ow">in</span> <span class="n">set_d</span> <span class="k">for</span> <span class="n">x</span> <span class="ow">in</span> <span class="n">a</span><span class="p">)</span> <span class="c1"># devolverá False na primeira divergência!
</span></code></pre></div></div>

<p>Então, essa solução é <code class="language-plaintext highlighter-rouge">O(len(d))</code> no melhor caso (o primeiro elemento de <code class="language-plaintext highlighter-rouge">a</code> não
está em <code class="language-plaintext highlighter-rouge">d</code>) e ainda será <code class="language-plaintext highlighter-rouge">O(len(a) + len(d))</code> no pior caso (todos os elementos
de <code class="language-plaintext highlighter-rouge">a</code> estão em <code class="language-plaintext highlighter-rouge">d</code>). Mas para <strong>listas pequenas</strong> (ou strings, tuplas, etc)
esse tipo de problema não é muito relevante.</p>

<h2 id="conclusão">Conclusão</h2>

<p>Eu espero que você tenha gostado deste texto! Se você conhece algum outro truque
legal usando <code class="language-plaintext highlighter-rouge">*</code> ou <code class="language-plaintext highlighter-rouge">**</code>, se você encontrou alguma coisa errada, ou se você tem
alguma sugestão, por favor me diga 
<a href="https://github.com/lucasoshiro/lucasoshiro.github.io/issues">aqui</a>.</p>

<h3 id="leitura-complementar">Leitura complementar</h3>

<ul>
  <li><a href="https://docs.python.org/3/library/dis.html">Documentação do disassembler do Python</a></li>
  <li><a href="https://pythonfluente.com/">Python Fluente, de Luciano Ramalho</a></li>
  <li><a href="https://wiki.python.org/moin/TimeComplexity">Complexidade de tempo em Python</a></li>
</ul>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Expandir argumentos é mais útil do que você pensa!]]></summary></entry><entry xml:lang="pt_br"><title type="html">Git: please stop squash merging!</title><link href="https://lucasoshiro.github.io/posts/2024-04-08-please_dont_squash/" rel="alternate" type="text/html" title="Git: please stop squash merging!" /><published>2024-04-08T00:00:00+00:00</published><updated>2024-04-08T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/please_dont_squash</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2024-04-08-please_dont_squash/"><![CDATA[<p><strong>TRADUÇÃO INCOMPLETA</strong></p>

<h2 id="intro">Intro</h2>

<p>It says “19 minute read”.</p>

<p>If you’re thinking “it’s easy, I’ll keep squashing so I can save those 19 minutes
of my life”, well, I must say that it is not an excuse, you can <strong>stop
squashing</strong> right now without reading this. But if you still thinking that using
squash merging is a good idea, please, keep reading this. You’ll probably won’t
want to squash your anymore after reading this, except in some <strong>very specific
cases</strong> (and those cases probably are not what you’re expecting).</p>

<p>This is long and dense, so, no more intro. Here we go!</p>

<h3 id="goals">Goals</h3>

<ul>
  <li>Explain what squash merges <strong>actually</strong> are, detailing how Git works under the
hood;</li>
  <li>Show how the most well-known “pros” about squash merging are conceptually <strong>wrong</strong>;</li>
  <li>Show situations that squash merges can be <strong>harmful</strong>;</li>
  <li>Show what you can (and should) do instead of using squash merge;</li>
</ul>

<h3 id="non-goals">Non-goals</h3>

<ul>
  <li>Tell something that works for me and dictating that it will also work for you;</li>
  <li>Create another “good practice guide” for people follow without questioning if
is true. <strong>Be skeptical</strong>;</li>
</ul>

<h3 id="why-do-you-use-squash-merge">Why do you use squash merge?</h3>

<p>If you consider that squash merge is a good practice, have you ever thought
<strong>why</strong> it is a good practice? Or are you only repeating something that you
have heard?</p>

<p>Be honest.</p>

<p>In the past, I also thought it was cool, but as I studied Git a little deeper
soon I figured out that it doesn’t make sense. Not only that, but it is <strong>never
mentioned</strong> as good practice in Git documentation, not even as a <em>practice</em>:</p>

<ul>
  <li>
    <p><a href="https://git-scm.com/book/en/v2">Pro Git</a> (the official Git book) has <strong>two
chapters</strong> and a appendix about <strong>merge</strong> and it barely mentions squash in the
merge context (it only mentions
<a href="https://git-scm.com/book/en/v2/Git-Tools-Advanced-Merging#_subtree_merge">here</a>
and
<a href="https://git-scm.com/book/en/v2/Git-and-Other-Systems-Git-as-a-Client#_git_branching_issues">here</a>,
using squash only as an intermediate tool);</p>
  </li>
  <li>
    <p>Apart from <code class="language-plaintext highlighter-rouge">git merge</code> manpage and Pro Git, the official Git <strong>documentation</strong> only mentions
squash in
<a href="https://git-scm.com/docs/gitfaq#Documentation/gitfaq.txt-Whatkindsofproblemscanoccurwhenmerginglong-livedbrancheswithsquashmerges">gitfaq</a>,
focusing on the <em>problems</em> of doing that;</p>
  </li>
  <li>
    <p>Last but not least, Git itself doesn’t have a single “squash and merge”
command, you have to run two commands to perform it (we’ll discuss about that later).</p>
  </li>
</ul>

<p>So, before we go deeper, I need you to ask you two things:</p>

<p>First, what do you think that a <strong>squash merge</strong> is?</p>

<textarea id="what_is_squash" style="border: 1px solid black;" placeholder="What do you think that squash is?"></textarea>

<p>(go ahead, write it, it’s only a textarea without any hidden JavaScript)</p>

<p>Second, why do you think you <strong>should do it</strong>, given the first answer?</p>

<textarea id="why_squash" style="border: 1px solid black;" placeholder="Why do you squash?"></textarea>

<p>Ok, thanks! We’ll come here later. Now, before I tell you why you shouldn’t
squash your commits (and before you squash your commits again), we need to have
it clear what a squash actually is. And I must say most people who squash do it
because they <strong>don’t know</strong> what a squash merge is. And, again, I must say this
is because they have two major misconceptions about Git.</p>

<p>There’s where we start.</p>

<h2 id="the-first-misconception-what-a-commit-stores">The first misconception: what a commit stores</h2>

<p>I strongly recommend you that you read <a href="https://git-scm.com/book/en/v2">Pro Git</a>, 
the official Git book. For our purposes here, <a href="https://git-scm.com/book/en/v2/Getting-Started-What-is-Git%3F">section 1.3</a>
and <a href="https://git-scm.com/book/en/v2/Git-Internals-Plumbing-and-Porcelain">chapter 10</a>
will be enough. But by now what we need to know from it is that <strong>Git commits don’t store changes</strong>.
They store <strong>snapshots</strong>.</p>

<p>Repeat after me: <strong>“Git commits don’t store changes, they store snapshots”</strong>.</p>

<p>And that’s the first misconception. When we’re using commands such as <code class="language-plaintext highlighter-rouge">git show</code>,
<code class="language-plaintext highlighter-rouge">git diff</code> or external tools such as the Pull Request UI on GitHub we think
that commits are sets of changes of states. But no, each commit <strong>is</strong> a state
plus some metadata.</p>

<p>Under the hood, Git stores the repository data in the so-called objects. Each
object stores data and is identified by its SHA-1 hash. Roughly saying, we have
three main types of objects:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/objects-en.svg" />
    <figcaption>Blob, commit, tree and branch. Sorry for the awful diagram...</figcaption>
  </figure>
</div>

<ul>
  <li><strong>Blob</strong>: contains file contents;</li>
  <li><strong>Tree</strong>: represents a directory. It is a list of files or directories, the
hash of their contents (a blob if it is a file or a tree if it is a directory)
and their file permissions;</li>
  <li><strong>Commit</strong>: contains the <strong>author</strong>, the <strong>commiter</strong>, its <strong>timestamp</strong> ,
its <strong>message</strong>, its <strong>parents</strong> and the <strong>snapshot</strong></li>
</ul>

<p>It is important to say that the child commit points to its parent or parents,
but the parent commit doesn’t point to its children. The first commit doesn’t
have any parent, and a merge commit has two parents or more. In the case of
merge commits, the parent order matters.</p>

<p>The <strong>snapshot</strong> of a commit is just the tree object that represents the root
directory of the commit when it was created.</p>

<p>Perhaps you are thinking: “that is not possible, that would be a waste of disk
space”. But that it is not true: a file that hasn’t changed between two commits
has the same content in both states, so their contents are stored in the same
blob. This is also true for directories.</p>

<p>And if you’re thinking “this is not true, I saw something about deltas, those
are the commit changes”, yeah, those deltas are changes but they are not changes
between commits. They are related to a compresion that Git does using something
called <a href="https://git-scm.com/book/en/v2/Git-Internals-Packfiles">packfile</a>, but
you don’t need to know about them by now. Only keep in mind that Git somehow
compresses the objects, so the disk space is not something you should care too
much.</p>

<p>Just one more thing: branches ares not objects. They are <strong>references</strong>, that is,
only pointers to commits. This is, there’s no such thing as “a commit is in a
branch”, as a branch is not a set of commits as we may think. But it is very
common to say that, even though it is not 100% correct. It is just a shorter
way to say “the commit is an ancestor of the commit pointed by the branch”.</p>

<p>For now on, sometimes I’ll refer to a commit pointed by a branch as just “a
branch”.</p>

<p>I disccussed a little more about objects
<a href="/posts-en/2022-03-12-merge-submodule/#brief-explaination-about-objects">here</a>,
but again, I strongly suggest you to read about that on Pro Git for more
datailed info.</p>

<h3 id="how-merge-works">How merge works</h3>

<p>Now that we know what a commit and a branch are, we can proceed to see how merge
works.</p>

<p>In Git, by “merge” we can think as three things, at least:</p>

<ol>
  <li>The <strong>command</strong> <code class="language-plaintext highlighter-rouge">git merge</code></li>
  <li>A <strong>merge commit</strong> (i.e. a commit with two or more parents)</li>
  <li>The <strong>mechanism</strong> used by <code class="language-plaintext highlighter-rouge">git merge</code> to join the contents of both branches</li>
</ol>

<p>When you run <code class="language-plaintext highlighter-rouge">git merge &lt;another branch&gt;</code>, you tell Git to join the contents of
both branches and create a <strong>merge commit</strong>. The merge commit will have as the first
parent the one pointed by the current HEAD and the commit pointed by the
merged branch as its second parent.</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/merge.svg" />
    <figcaption>Merging B on A</figcaption>
  </figure>
</div>

<p>When the commit of the current branch is a direct ancestor of the commit of the
merged branch, Git will perform a <strong>fast-forward</strong>. Fast forwards don’t create
merge commits, they only make the current branch point to the same commit as the
merged branch, so they are not true merges. You can change this behaviour by
using <code class="language-plaintext highlighter-rouge">--no-ff</code>. GitHub also provides a feature for merging PRs without
fast-forwarding them in those cases. Personally, I don’t like fast-forwards, so
I use no fast forward when possible.</p>

<p>So, by now we know what is 1 (<code class="language-plaintext highlighter-rouge">git merge</code>) and 2 (merge commit), but what about
3? What is the <strong>mechanism</strong> that Git uses to join the files of both branches? Well,
Git performs an algorithm called <strong>three-way merge</strong> that uses the snapshots of
three commits in order to figure out what should be kept in the merge commit and
what should not:</p>

<ul>
  <li>the commit pointed by the <strong>current branch</strong> (named A);</li>
  <li>the commit pointed by the branch that we <strong>want to merged</strong> (named B);</li>
  <li>the commit that is the last <strong>common ancestor</strong> between A and B (named O).</li>
</ul>

<p>When performing a three-way merge, Git will keep everything that are the same
in A and B. If there’s something different, it will compare O and A, and O and
B. If something doesn’t changed from O to A but changed from O to B, it keeps
the change introduced in B, and vice-versa. If O, A and B differ, then we have a
conflict and you need to manually fix it.</p>

<p>This picture shows how the three-way merge works. Different colors means
different contents of a file:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/3-way-merge-en.svg" />
    <figcaption>Three-way merge</figcaption>
  </figure>
</div>

<blockquote>
  <p>Note: for plaintext files, if there’s a conflict Git will perform three-way
merge comparing the lines, so it can merge the contents of a file that don’t
overlap. If there’s a overlap, then it puts the conflict marks.</p>
</blockquote>

<p>This mechanism is also used in other commands, such as cherry-pick,
revert, rebase and stash, but this is a topic for another post.</p>

<p>This is really brief explanation about merge and there’s a lot to talk about
(e.g. how Git handles renames, file permissions, submodules and so on).
<a href="/posts-en/2022-03-12-merge-submodule/#brief-explanation-about-merge">Here</a>
I discussed a little more about merge, but by now this is enough.</p>

<blockquote>
  <p>As an exercise: try to imagine how hard and expensive merge would be if Git
stored changes instead of snapshots.</p>
</blockquote>

<h3 id="what-squash-merge-actually-is">What squash merge <em>actually</em> is</h3>

<p>By now, we know what is a merge. But how about a squash merge? I just googled
“why squash merge?” and I found these definitions about what it is:</p>

<ul>
  <li>
    <p>“Instead of each commit on the topic branch being added to the history of the
default branch, a squash merge adds all the file changes to a single new
commit on the default branch”</p>
  </li>
  <li>
    <p>“It turns all your changes into one single commit and then adds that to the
main branch”</p>
  </li>
  <li>
    <p>“By squashing commits, developers can condense a series of small, incremental
changes into a single meaningful change”</p>
  </li>
  <li>
    <p>“Squashing retains the changes but discards all the individual commits”</p>
  </li>
</ul>

<p>Well, time to revisit your answer. Click <a href="#what_is_squash">here</a> to see it. Is
your answer similar to those? Well, I ask you that because there’s something
that all those answers have in common: <strong>they are all wrong!</strong></p>

<p>And they are wrong because, remember: <strong>Git commits don’t store changes, they store snapshots</strong>.</p>

<p>Again: <strong>Git commits don’t store changes, they store snapshots</strong>.</p>

<p>Now, an exercise: try to rewrite those answers (or your answer, if it has the
same idea) replacing the <em>wrong</em> idea of commits storing changes by the
<em>correct</em> idea of commits storing snapshots. Here’s another textarea only for
your convenience:</p>

<textarea style="border: 1px solid black;" placeholder="Come on, write!"></textarea>

<p>Was it hard? Well, this is because that idea of <strong>what a squash merge is</strong> is
based on a wrong idea of <strong>what Git is</strong>, and it doesn’t make any sense in real
life.</p>

<p>I bet that if you regularly squash merge you do it by using the UI of GitHub or
similar, and you never did it locally on your machine through CLI, using this
button:</p>

<div class="img-container">
  <figure>
  <div style="padding-left: 25%; padding-right: 25%">
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/merge_button.png" />
  </div>
    <figcaption>Merge options on GitHub. One of them is squash and merge</figcaption>
  </figure>
</div>

<p>And I say that because, as I said before, <strong>there’s no command for squash
merging</strong> in Git! In fact, in order to do the same thing as the “squash and
merge” button on GitHub you’ll need <strong>two commands</strong>:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git merge <span class="nt">--squash</span> another_branch
git commit
</code></pre></div></div>

<p>Several useful Git commands that are a single command originally were a set of
commands, such as <a href="https://marc.info/?l=git&amp;m=118318197312297&amp;w=2"><code class="language-plaintext highlighter-rouge">git stash</code></a>,
<a href="https://marc.info/?l=git&amp;m=132569307707479&amp;w=2"><code class="language-plaintext highlighter-rouge">git subtree</code></a> and so on, but this
never managed (at least so far) to be a single command. That should raise an
alert on you that something is out of place here.</p>

<p>Let’s check what happens when we perform a squash merge locally:</p>

<ul>
  <li>
    <p>The first command is the squash itself. It merges the current branch with the
other one, but it <strong>doesn’t create a merge commit</strong>. Instead, it only merges
the files (using the mechanism that we discussed before) in the filesystem (in
Git jargon, working directory) and stages them just like <code class="language-plaintext highlighter-rouge">git add</code> does (in
Git jargon, it adds them to the index);</p>
  </li>
  <li>
    <p>The second command is just a standard <code class="language-plaintext highlighter-rouge">git commit</code>. When we perform a <code class="language-plaintext highlighter-rouge">git
commit</code> we create a new commit after the state of the index (the staging
area), that contains the merged files and the untouched ones. The previous
step creates a commit message containing a list of the messages of the branch
that was squashed, and it is used as template here.</p>
  </li>
</ul>

<p>A <strong>commit</strong> whose <strong>contents are a merge</strong> of the two merged branches. Hmmmm, sounds
familiar? Isn’t it a <strong>merge commit</strong>?</p>

<p>Oh wait, <strong>isn’t it a merge commit????</strong></p>

<p><strong>Are squash merge and standard merge the same??</strong></p>

<p><strong>WHAT???</strong></p>

<p>Please, calm down. They are different. How? Remember that a <strong>merge commit</strong> has
<strong>two</strong> or more parents? That’s the difference. This commit has only <strong>one</strong>
parent: the commit pointed by the current branch before merging. This way,
there’s no reference to the other branch, and that’s <strong>the only difference</strong>
between the squash merge commit and the true merge commit.</p>

<!-- TA ERRADO -->
<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/squash_merge-en.svg" />
    <figcaption>Squash merging B on A</figcaption>
  </figure>
</div>

<p>Don’t you believe? What more could change?</p>

<ul>
  <li>The author, commiter, timestamps or message? These are only metadata;</li>
  <li>The snapshot? No, it is the same, as it was generated by the same mechanism.</li>
</ul>

<p>The only thing left is the parents. <strong>Squash merge</strong> is the same as the <strong>true
merge</strong> but with a missing information: the <strong>reference to the merged branch</strong>.</p>

<p>Why is it good?</p>

<p>Is it good?</p>

<p>This leads to the second misconception.</p>

<h2 id="the-second-misconception-the-fallacy-of-the-clean-history">The second misconception: the fallacy of the clean history</h2>

<p>I don’t know if you still think that squash is a good idea after knowing what it
really is. But anyway, let’s read again why you think that squash merges are
good: <a href="#why_squash">click here</a>.</p>

<p>Just like I did before, here are some answers from some of the first results
after a quick Google search for “why squash merge”:</p>

<ul>
  <li>“Squash merging keeps your default branch histories clean”</li>
  <li>“Your base branch remains clean”</li>
  <li>“This helps developers to maintain a clean Git commit history”</li>
  <li>“This [squash merging] helps keep your code history clean”</li>
</ul>

<p>See? It is very common to say that squash merges keeps the history clean.  And,
was we saw, the only difference between the squash merges and true merges is
that squash merges don’t preserve the reference to the original branch, so
“clean” in this situation means “less information” and “less commits”.  And I
ask you: why a commit history with fewer commits are the better? Here’s another
textar… (no, enough textareas!)</p>

<p>If it was true, the best commit history would be not <em>commiting at all</em>. So, the best way
to use Git would be not using Git. Something is wrong here.</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-04-08-please_dont_squash/clean_history-en.svg" />
    <figcaption>The best Git history is not using Git at all (<b>this is a joke</b>)</figcaption>
  </figure>
</div>

<p>That is our second misconception. Cleaner commit histories are better, indeed,
but a history with <strong>fewer commits is not cleaner</strong>. So, what is a good commit
history?</p>

<h3 id="a-good-commit-history">A good commit history</h3>

<p>A good commit history is a history that contains <strong>good commits</strong>.</p>

<p>Personally, I’m intrigued that it is a common sense that most developers agree
that <strong>code quality</strong> and <strong>data quality</strong> are important while it is harder to
find someone that really cares about the <strong>code repository quality</strong>.
And the repository is the <strong>database where we store code</strong>.</p>

<div class="img-container">
  <figure>
  <div style="padding-left: 25%; padding-right: 25%">
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/data_repo_code-en.svg" />
    </div>
    <figcaption>Your project repository is both a codebase and a database.</figcaption>
  </figure>
</div>

<p>Lets recap some practices that we commonly associate with <strong>code quality</strong>:</p>

<ul>
  <li>Code that is <strong>easy to understand</strong>;</li>
  <li>Code that implements <strong>simple solutions</strong>;</li>
  <li>Code that is <strong>easy to debug</strong>, when needed;</li>
  <li>Code that is <strong>simple</strong>;</li>
  <li>Code that can be <strong>tested</strong>;</li>
  <li>Code that follow the same <strong>codestyle</strong>;</li>
  <li>Good <strong>documentation</strong>.</li>
</ul>

<p>And about <strong>data quality</strong>:</p>

<ul>
  <li>Data that is <strong>easy to retrieve</strong>;</li>
  <li>Data that is <strong>accurate</strong>;</li>
  <li>Data that is <strong>clean</strong>.</li>
</ul>

<p>I don’t want to write a commit guideline here, but there is <strong>a lot</strong> of good
resources that you can read about. I’ll leave some of them at the
<a href="#further-reading">bottom of this page</a>. I don’t think that you should follow them as a
religion (I think that you should follow them as long as them make sense), but
there are some practices that worth be mentioned here:</p>

<ol>
  <li><strong>Atomic changes</strong>: each commit should introduce an indivisible codeset;</li>
  <li><strong>Write good commit messages</strong>: use the commit message to describe the change
you introduced;</li>
  <li><strong>Don’t commit incomplete work</strong>: if it is not ready, then don’t commit (use
the staging area);</li>
</ol>

<p>And we if we do that, we’ll have <strong>more commits</strong>, but they will be
<strong>good commits</strong>.  They will be <strong>meaningful</strong> and they will be easier to debug with
tools such as the ones that I mentioned
<a href="/posts-en/2023-02-13-git-debug">here</a>. Not only that, it will
be easier to <strong>cherry-pick</strong> and <strong>revert</strong> specific changes.</p>

<p>There are some commit guidelines, I don’t think that you need to adopt any
specific one, but you can take a look a decide if they make sense to you. Or
they can be a inspiration for you create your own:</p>

<ul>
  <li>
    <p>the Linux kernel, that is the project that
<a href="https://git-scm.com/book/en/v2/Getting-Started-A-Short-History-of-Git">Git was created for</a>
has a <a href="https://kernelnewbies.org/PatchPhilosophy">strict guideline</a> for writing
patches (commits that are sent by email). I also had a
<a href="https://marc.info/?l=linux-iio&amp;m=154880250923042&amp;w=2">patch that was rejected</a>
by doing too much, and I need to rewrite my history and send again.</p>
  </li>
  <li>
    <p>the <a href="https://www.conventionalcommits.org/en/v1.0.0/">conventional commits</a>
specification is less strict then the Linux kernel, as several projects follow
them;</p>
  </li>
  <li>
    <p><a href="https://gitmoji.dev">Gitmoji</a> is similar to conventional commits, but it uses
emoji to identify the commit types (for good or for bad).</p>
  </li>
</ul>

<p>For example, <a href="https://marlinfw.org">Marlin</a>, a firmware for 3D printers, uses
Gitmoji. Look how it is easy to find commits with bugfixes:</p>

<div class="img-container">
  <figure>
  <div style="padding-left: 0%; padding-right: 0%">
    <img class="small" src="/assets/images/posts/2024-04-08-please_dont_squash/Marlin.png" />
  </div>
    <figcaption>Searching bugfixes on Marlin</figcaption>
  </figure>
</div>

<p>Last but not least: <strong>don’t fear rewriting history</strong>. Of course it can be
dangerous, but you can use it in your favor to create a clean commit history. I 
suggest you to read <a href="https://matheustavares.gitlab.io/posts/rewriting-history-101">this</a>.
I also suggest you to include <strong>commit history reviewing</strong> to your code
reviewing process, just like the Linux kernel does (and rejecting bad commit
histories like they did with me!).</p>

<h2 id="when-squash-can-be-evil">When squash can be evil</h2>

<p>I think I have enough evidence for you to see that squash is not exactly
something good and the arguments to use it are based on wrong principles of what
Git is and what are a so called clean history. But if you asking if there’s a
case where squash merges can <strong>break</strong> something, I once saw it silently
breaking a repository with <strong>submodules</strong> as a consequence of not having the
reference of the merged branch.</p>

<p>At first I started to write about that situation but I thought it will make this
article even longer than it already is, so I wrote another article only about
it <a href="/posts-en/2024-06-27-squash-submodule">here</a>.</p>

<div class="img-container">
  <figure>
  <div style="padding-left: 25%; padding-right: 25%">
    <img class="small" src="/assets/images/posts/2024-04-08-please_dont_squash/evil_squash.svg" />
  </div>
    <figcaption>This squash may look cute, but it is evil. </figcaption>
  </figure>
</div>

<h2 id="so-what-should-i-do">So, what should I do?</h2>

<p>If you are used to perform squash merges probably you are thinking “what should
I do?”, because it still feels comfortable to keep squashing even though you
they are not the best choice. Let’s do the right things from now on.</p>

<h3 id="but-squashing-makes-my-life-so-easy">But squashing makes my life so easy…</h3>

<p>Let’s imagine you are driving a car with manual transmission. You have 5 forward
gears and one reverse. Do you think it is a good idea to drive your car
backwards because you don’t want to shift gears? I hope you don’t, and I hope
that you at least suspect that the car have 5 gears instead of 1 because things
<strong>are not so easy</strong> and <strong>pretending they are easy</strong> is not the solution
(err… unless you drive an automatic).</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-04-08-please_dont_squash/transmission.png" />
    <figcaption>R doesn't mean "Run"</figcaption>
  </figure>
</div>

<p>And here it is the same. We need to understand our tools and how to use them.</p>

<p>Some people say: “if you squash you have a linear history, only seeing the merge
commits”. Ok, but you can see it without squashing (and without losing the
original commits) by running:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git log <span class="nt">--first-parent</span>
</code></pre></div></div>

<p>“Squash merges are easy to revert”:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git revert <span class="nt">-m</span> 1 &lt;commit&gt;
</code></pre></div></div>

<p>“Squash merges are easy to cherry-pick”:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git cherry-pick <span class="nt">-m</span> 1 &lt;commit&gt;
</code></pre></div></div>

<p>“Squash merges are easy to <code class="language-plaintext highlighter-rouge">&lt;insert something&gt;</code>”: read the documentation about
how to do <code class="language-plaintext highlighter-rouge">something</code> properly! <strong>No excuses!</strong></p>

<h3 id="if-you-are-convinced">If you are convinced…</h3>

<p>Here are some things that you can do:</p>

<ul>
  <li>
    <p>Try to write <strong>meaningful commits</strong> like we discussed before. It is hard at
first, but it will soon become easy and it will pay your effort;</p>
  </li>
  <li>
    <p>On you code reviews, also <strong>review the commit history</strong>. Check if it is clean
and, if it is not, ask to the author of the code to rewrite the history, just
like you would do with code;</p>
  </li>
  <li>
    <p>If you are a junior developer, listen to the seniors developers but don’t take
everything that they say as true. <strong>Question everything</strong>, and that will make
you grow;</p>
  </li>
  <li>
    <p>If you are a senior, <strong>don’t tell juniors to do something that you aren’t
certain that is right</strong> and that you <em>believe</em> that it is right
because another <em>senior</em> told you to do that when you were a junior. Don’t be
a parrot;</p>
  </li>
  <li>
    <p>The same applies here. Question <strong>everything</strong> that I said. Don’t do
anything only because I told here.</p>
  </li>
</ul>

<h3 id="if-you-are-not-convinced">If you are not convinced…</h3>

<p>I tried to do my best.</p>

<h2 id="is-there-any-good-use-case-for-squash-merge">Is there any good use case for squash merge?</h2>

<p>Oh yeah, of course. It is <strong>a tool</strong> just like many others that Git has, so of
course it can be useful! But there are a lot of <strong>more useful</strong> Git tools that
people generally don’t know, for example, some searching and debugging tools
that I explained <a href="/posts-en/2023-02-13-git-debug">here</a>.</p>

<p>I stopped to think for about two minutes in a use case for squash. And here it
is one: supposing that you have an old branch with only one commit diverging
from your main. Now you want to merge it, but the main branch changed so much
that the code would need to be compatible with those changes.</p>

<!-- figura errada -->
<div class="img-container">
  <figure>
  <div style="padding-left: 25%; padding-right: 25%">
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/useful_squash.svg" />
  </div>
    <figcaption> This is the situation </figcaption>
  </figure>
</div>

<p>An option here is to rebase <code class="language-plaintext highlighter-rouge">foo</code> onto <code class="language-plaintext highlighter-rouge">main</code>, make the code compatible with the
new <code class="language-plaintext highlighter-rouge">main</code>, and then <code class="language-plaintext highlighter-rouge">git commit --amend</code>. Other is to cherry-pick foo (in
practice, it would be the same as rebasing). But you can also do this:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git checkout main
git checkout <span class="nt">-b</span> bar
git merge <span class="nt">--squash</span> foo

<span class="c"># edit the code in order to make it compatible</span>

git commit
</code></pre></div></div>

<p>In that situation, we’re using <code class="language-plaintext highlighter-rouge">git merge --squash</code> to apply the changes
introduced in <code class="language-plaintext highlighter-rouge">foo</code> to our files, without commiting. Then we make the code
compatible and create a new commit.</p>

<div class="img-container">
  <figure>
  <div style="padding-left: 20%; padding-right: 20%">
    <img class="large" src="/assets/images/posts/2024-04-08-please_dont_squash/useful_squash_2.svg" />
  </div>
    <figcaption> After squashing `foo` on `bar`, changing it, and then commiting.</figcaption>
  </figure>
</div>

<p>And that’s it. A simple tool that may be useful in very specific situations.</p>

<h2 id="conclusion">Conclusion</h2>

<p>Thanks for your time! I hope that this may be useful.
If something is wrong, please open a
<a href="https://github.com/lucasoshiro/lucasoshiro.github.io/issues">issue</a>.</p>

<p>And for the last time, remember:
<strong>Git commits don’t store changes, they store snapshots</strong>!</p>

<h3 id="further-reading">Further reading</h3>

<p>The references that I mentioned in this text are listed here.</p>

<p>For general Git information:</p>

<ul>
  <li><a href="https://git-scm.com/book/pt-br/v2">Pro Git</a> by Scott Chacon: It’s the
official Git Book. I’ll select the sections that are most important here.</li>
</ul>

<p>About Git internals:</p>
<ul>
  <li><a href="https://git-scm.com/book/en/v2/Getting-Started-What-is-Git">Pro Git - What is Git</a>:
explains what Git is and compares it with delta-based versioning systems;</li>
  <li><a href="https://git-scm.com/book/en/v2/Git-Internals-Plumbing-and-Porcelain">Pro Git - Git Internals</a>:
explains how Git works under the hood.</li>
</ul>

<p>About merge:</p>
<ul>
  <li><a href="https://en.wikipedia.org/wiki/Merge_(version_control)">Wikipedia - Merge (version control)</a>:
explains merge and three way merge</li>
</ul>

<p>About commiting:</p>
<ul>
  <li><a href="https://cbea.ms/git-commit/">How to Write a Git Commit Message</a> by
cbeams: Advices about what to put in a commit message;</li>
  <li><a href="https://matheustavares.gitlab.io/slides/git_101.pdf">Git 101</a> by Matheus
Tavares: it’s a general presentation about Git but it focus on commits after
slide 29;</li>
  <li><a href="https://www.git-scm.com/book/en/v2/Distributed-Git-Contributing-to-a-Project#_commit_guidelines">Pro Git - commit guidelines</a>:
chapter of Pro Git about how to commit;</li>
  <li><a href="https://kernelnewbies.org/PatchPhilosophy">Philosophy of Linux kernel patches</a>:
about patches (commits) in the Linux Kernel;</li>
  <li><a href="https://www.conventionalcommits.org/en/v1.0.0/">Conventional Commits v1.0.0</a>:
a convention about commits that is adopted by several projects;</li>
  <li><a href="https://gitmoji.dev">Gitmoji</a>:  similar to conventional commits, but using emoji.</li>
</ul>

<p>About rewriting history:</p>
<ul>
  <li><a href="https://matheustavares.gitlab.io/posts/rewriting-history-101">Git: Rewriting History 101</a>
by Matheus Tavares: about when, how and why rewrite the commit history;</li>
  <li><a href="https://git-scm.com/book/en/v2/Git-Tools-Rewriting-History">Pro Git - rewriting history</a>:
Chapter of Pro Git about rewriting history.</li>
</ul>

<p>About squash merging (note that both discuss about the fallacy of the clean history):</p>
<ul>
  <li><a href="https://dev.to/wesen/squash-commits-considered-harmful-ob1">Squash commits considered harmful</a>
by Manuel Odendahl. After writing some sections here I found this article
that is quite similar;</li>
  <li><a href="https://medium.com/bananatag-engineering-blog/squash-merges-are-evil-171f55139c51">Squash merges are evil</a> by
L. Holanda. Another good article against squash merge.</li>
</ul>

<p>Other articles about Git that I wrote:</p>

<ul>
  <li><a href="https://lucasoshiro.github.io/posts-en/2023-02-13-git-debug/">Git as debugging tool</a>;</li>
  <li><a href="https://lucasoshiro.github.io/posts-en/2022-03-12-merge-submodule/">Git: merge with submodules</a>;</li>
  <li><a href="/posts-en/2024-06-27-squash-submodule">Git: the danger of squash merging submodules</a>.</li>
</ul>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[At least not before reading this!]]></summary></entry><entry xml:lang="pt_br"><title type="html">Curso de OpenSCAD</title><link href="https://lucasoshiro.github.io/posts/2024-03-24-openscad/" rel="alternate" type="text/html" title="Curso de OpenSCAD" /><published>2024-03-24T00:00:00+00:00</published><updated>2024-03-24T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/openscad</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2024-03-24-openscad/"><![CDATA[<p>Em janeiro de 2024, eu dei um
<a href="https://www.ime.usp.br/verao/index.php/turmas/descricao/482">curso</a> sobre
OpenSCAD e como usá-lo para impressão 3D.</p>

<p>Para aqueles que não conhecem, o OpenSCAD é um programa e uma linguagem de
programação para a modelagem de objetos 3D, principalmente para impressão
3D. Sendo uma linguagem de programação, ele pode ser muito produtivo para 
modelagem, já que ele é completamente parametrizável e tem várias bibliotecas.</p>

<p>Esse curso foi um desafio pessoal, já que:</p>
<ul>
  <li>foi o primeiro curso que preparei e lecionei;</li>
  <li>provavelmente é o primeiro curso de OpenSCAD em português;</li>
  <li>o público era incrivelmente diverso, já que era composto por aproximadamente
50 pessoas de diferentes áreas profissionais (desenvolvedores de software,
professores de matemática, engenheiros e até dentistas!), algumas pessoas
sabiam muito sobre programação e outros mal sabiam o que eram isso e a maioria
nunca usou uma impressora 3D!</li>
</ul>

<p>Esses são os slides de cada aula:</p>

<ol>
  <li><a href="/assets/pdf/2024-03-24-openscad/1.pdf">Aula 1</a>:
Introdução ao OpenSCAD, instalação, comparação com outras ferramentas;</li>
  <li><a href="/assets/pdf/2024-03-24-openscad/2.pdf">Aula 2</a>:
Intrdoução à linguagem de programação do OpenSCAD, focando em aspectos de
programação como tipos de dados, funções, operadores e por aí vai;</li>
  <li><a href="/assets/pdf/2024-03-24-openscad/3.pdf">Aula 3</a>: Objetos 3D
primitivos e operações sobre eles;</li>
  <li><a href="/assets/pdf/2024-03-24-openscad/4.pdf">Aula 4</a>: Controle
de fluxo e reuso de código, com módulos e bibliotecas;</li>
  <li><a href="/assets/pdf/2024-03-24-openscad/5.pdf">Aula 5</a>: Extrusão
de 2D para 3D, importação de arquivos STL e SVG;</li>
  <li><a href="/assets/pdf/2024-03-24-openscad/6.pdf">Aula 6</a>:
Boas práticas de programação, linha de comando, integração com Python,
impressão 3D.</li>
</ol>

<p>Esses slides são apenas uma referência. O curso em si foi mais do que isso. Toda
aula demonstrei tudo que está contido nesses lides, programei/modelei ao vivo e
mostrei passo a passo o raciocínio de como modelar. Além disso, também tinha
tarefas para os alunos fazerem após cada aula e que não estão aqui.</p>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Curso de introdução ao OpenSCAD]]></summary></entry><entry xml:lang="pt_br"><title type="html">Tutorial: Configurando um ambiente de desenvolvimento com Lima</title><link href="https://lucasoshiro.github.io/posts/2024-02-29-lima-development-setup/" rel="alternate" type="text/html" title="Tutorial: Configurando um ambiente de desenvolvimento com Lima" /><published>2024-02-29T00:00:00+00:00</published><updated>2024-08-23T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/lima-development-setup</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2024-02-29-lima-development-setup/"><![CDATA[<p>Os novos Macs com Apple Silicon (M1, M1 Pro, M1 Ultra, M2 e por aí vai) são
ótimas máquinas, e talvez você goste bastante do macOS (bom, eu sou um fanboy do
Manjaro que também tem um MacBook Air, e eu gosto bastante dele). Porém, esse
novo ecossistema Mac/ARM pode ser frustrante se você precisar desenvolver para o
bom e velho Linux/x86-64:</p>

<ul>
  <li>Os Macs Intel podiam fazer dual-boot de macOS e Linux (e até mesmo
Windows!). Os Mac Apple Silicon não conseguem;</li>
  <li>Ok, isso não é totalmente verdade porque a equipe do
<a href="https://asahilinux.org/">Asahi Linux</a> têm trabalhado pesado para conseguir
rodar o Linux nativamente no Apple Silicon. Porém, apesar do incrível
progresso deles, ele <strong>ainda</strong> não está 100%, e é um Linux ARM;</li>
  <li>O VirtualBox para o Apple Silicon praticamente não existe até agora (quer
dizer, tem um beta que não fazia quase nada e que desapareceu da
<a href="https://www.virtualbox.org/wiki/Downloads">página de downloads</a>);</li>
  <li>O Parallels existe, mas você precisa pagar pra usar;</li>
  <li>Tem o <a href="https://www.qemu.org/">QEMU</a>. Não me entenda mal, o QEMU é excelente,
mas ele pode ser bem chato de configurar e executar através da linha de
comando (em comparação ao VirtualBox, por exemplo);</li>
  <li>Ainda existe o <a href="https://mac.getutm.app/">UTM</a>, um front-end para o QEMU, mas
ele não roda máquinas x86-64 e
<a href="https://www.appelgriebsch.org/005-utm/">não é tão fácil instalar uma distro ARM</a> nele.</li>
</ul>

<p>Mas pera aí, não jogue fora seu belo Mac, ainda tem mais uma opção para você: o 
<a href="https://github.com/lima-vm/lima">Lima</a>. Ele é um wrapper para o QEMU que
permite que você crie facilmente máquinas virtuais Linux ARM e x86-64.</p>

<p>Mas ele tem algumas desvantagens:</p>

<ul>
  <li>É uma ferramenta de linha de comando, não tem uma interface gráfica;</li>
  <li>Você até pode rodar alguns apps com interface gráfica, mas a experiência não é
das melhores;</li>
  <li>A interoperabilidade com o macOS é meio fraca.</li>
</ul>

<p>Neste tutorial vou te mostrar como configurar uma instância de Linux x86-64 no
Lima, e como usar ela em seu ambiente de desenvolvimento. Note que você
precisará rodar comandos no Mac hospedeiro e no Linux convidado, então eu vou
representar seus prompts como <code class="language-plaintext highlighter-rouge">mac$</code> e <code class="language-plaintext highlighter-rouge">linux$</code> para deixar claro onde que você
deve rodar cada comando.</p>

<h2 id="instalando-o-homebrew">Instalando o Homebrew</h2>

<p>Se você já tem o <a href="https://brew.sh/">Homebrew</a> instalado, você pode pular esta
seção. Mas se você não o tem, eu recomendo fortemente que você o instale, já que
ele é um gerenciador e instalador de pacotes para o Mac, assim como o
<code class="language-plaintext highlighter-rouge">apt-get</code>/<code class="language-plaintext highlighter-rouge">dpkg</code> é para o Debian/Ubuntu/Mint e o <code class="language-plaintext highlighter-rouge">pacman</code> é para o Arch/Manjaro.</p>

<p>Você pode instalar o homebrew executando em seu terminal:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>/bin/bash <span class="nt">-c</span> <span class="s2">"</span><span class="si">$(</span>curl <span class="nt">-fsSL</span> https://raw.githubusercontent.com/Homebrew/install/HEAD/install.sh<span class="s2">")
</span></code></pre></div></div>

<blockquote>
  <p>Tome cuidado!</p>

  <p>Não copie e cole nada em seu terminal a não ser que você confie na pessoa que 
disse para você fazer isso!</p>

  <p>Se você não confia em mim então copie direto de <a href="https://brew.sh/">https://brew.sh/</a> !</p>
</blockquote>

<h2 id="instalando-o-lima">Instalando o Lima</h2>

<p>Ok, tendo o Homebrew instalado, execute:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>brew <span class="nb">install </span>lima
</code></pre></div></div>

<p>Você pode ver se a instalação deu certo executando:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>limactl <span class="nt">--version</span>
</code></pre></div></div>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-02-29-lima-development-setup/lima-version.png" />
  </figure>
</div>

<h2 id="visão-geral-do-lima">Visão geral do Lima</h2>

<p>Como eu disse antes, o Lima usa o QEMU por debaixo dos panos, e ele gerencia
máquinas virtuais (também chamadas de instâncias aqui). <code class="language-plaintext highlighter-rouge">limactl</code> é o comando
que você usa para interagir com o Lima. Aqui estão alguns subcomandos do
<code class="language-plaintext highlighter-rouge">limactl</code> (você pode ver mais deles rodando <code class="language-plaintext highlighter-rouge">limactl --help</code>):</p>

<ul>
  <li><code class="language-plaintext highlighter-rouge">limactl list</code>: lista VMs;</li>
  <li><code class="language-plaintext highlighter-rouge">limactl create</code>: cria uma VM;</li>
  <li><code class="language-plaintext highlighter-rouge">limactl shell</code>: executa um shell em uma VM;</li>
  <li><code class="language-plaintext highlighter-rouge">limactl start</code>: inicia uma VM;</li>
  <li><code class="language-plaintext highlighter-rouge">limactl stop</code>: encerra uma VM.</li>
</ul>

<p>Se você executar <code class="language-plaintext highlighter-rouge">limactl list</code> você não vai ver nada por enquanto. Isso é
porque você não tem nenhuma instância, então você vai precisar criar uma com
<code class="language-plaintext highlighter-rouge">limactl create</code>.</p>

<p>Depois de criar uma, você deverá inciá-la com <code class="language-plaintext highlighter-rouge">limactl start</code>. Se você não
precisa mais ter ela em execução, você pode pará-la com <code class="language-plaintext highlighter-rouge">limactl stop</code>
(instâncias do Lima podem desperdiçar sua bateria…). Depois de iniciada, você
pode executar <code class="language-plaintext highlighter-rouge">limactl shell</code> e isso vai iniciar um shell (provavelmente Bash)
em sua VM.</p>

<p>Note que apenas encerrar o shell não encerra a instância. Note também que essas
são VMs com armazenamento persistente, você não irá perder seus arquivos e
configurações depois de encerrá-las.</p>

<h2 id="criando-uma-instância-x86-64">Criando uma instância x86-64</h2>

<p>Por padrão, se você executar <code class="language-plaintext highlighter-rouge">limactl create</code> em um Apple Silicon, o Lima vai
criar uma instância ARM. Então, você precisa especificar que você quer uma
instância x86-64 com <code class="language-plaintext highlighter-rouge">--arch=x86-64</code>:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>limactl create <span class="nt">--arch</span><span class="o">=</span>x86_64 template://debian
</code></pre></div></div>

<p>Como você deve suspeitar, estamos criando uma máquina virtual Debian, mas você
pode escolher qualquer distro que você quiser (se suportar x86-64) se ela estiver
<a href="https://lima-vm.io/docs/templates/">nesta lista</a>. Apenas se assegure que existe
uma imagem x86-64 para ela! E você pode ter tanto instancias x86-64 quanto ARM!</p>

<p>Agora execute:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>limactl list
</code></pre></div></div>

<p>Se tudo estiver ok você deverá ver sua nova instância <code class="language-plaintext highlighter-rouge">debian</code> aqui!</p>

<h2 id="configurando-o-ssh-para-a-sua-instância">Configurando o SSH para a sua instância</h2>

<p>Como eu tinha dito antes, a interoperabilidade entre o hospedeiro Mac e as
instâncias do Lima é… estranha. O lima pode ler os arquivos do Mac mas não
pode escrever neles. Os hosts Mac não podem ler nem escrever instâncias do Lima
(ok, tem uma exceção para isso mas ela não é recomendada).</p>

<p>Mas nós podemos configurar o SSH para ter uma interoperabilidade aqui. Execute:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>limactl edit debian
</code></pre></div></div>

<p>Ele vai abrir um editor de texto (aquele que estiver configurado na variável de
ambiente <code class="language-plaintext highlighter-rouge">EDITOR</code>, você pode trocá-lo pelo seu favorito como <code class="language-plaintext highlighter-rouge">vim</code>, <code class="language-plaintext highlighter-rouge">emacs</code>,
<code class="language-plaintext highlighter-rouge">code</code> e por aí vai antes de executar isso).</p>

<p>Adicione isso ao fim do arquivo:</p>

<div class="language-yaml highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="na">ssh</span><span class="pi">:</span>
  <span class="na">localPort</span><span class="pi">:</span> <span class="m">2022</span>
</code></pre></div></div>

<p>Isso vai configurar a porta SSH padrão. Você pode configurar a porta SSH para a
que você quiser.</p>

<h2 id="adicionando-a-vm-como-um-host-ssh-no-sshssh_config">Adicionando a VM como um host SSH no <code class="language-plaintext highlighter-rouge">.ssh/ssh_config</code></h2>

<p>Isso só é necessário se você está usando Visual Studio Code, mas eu recomendo
fazer isso de qualquer jeito.</p>

<p>Adicione em seu <code class="language-plaintext highlighter-rouge">~/.config/ssh_config</code> as seguintes linhas:</p>

<div class="language-config highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="n">Host</span> <span class="n">lima</span>-<span class="n">debian</span>
  <span class="n">HostName</span> <span class="n">localhost</span>
  <span class="n">Port</span> <span class="m">2022</span>
</code></pre></div></div>

<p>Isso vai identificar a VM para o SSH como <code class="language-plaintext highlighter-rouge">lima-debian</code>. Mude a porta para
aquela que você escolheu no passo anterior.</p>

<h2 id="executando-sua-instância">Executando sua instância</h2>

<p>Ok, vamos executar sua instância x86-64 pela primeira vez. Execute:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>limactl start debian
</code></pre></div></div>

<p>Como essa é a primeira vez, isso pode levar alguns minutos para terminar. Se
tudo foi ok, execute:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac<span class="nv">$ </span>limactl shell debian
</code></pre></div></div>

<p>Isso vai abrir um shell (neste caso, o Bash) na sua instância. Se você não
acredita que esse é um Linux x86-64, você pode ver isso assim:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>linux<span class="nv">$ </span><span class="nb">uname</span> <span class="nt">-a</span>
</code></pre></div></div>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-02-29-lima-development-setup/uname.png" />
  </figure>
</div>

<h3 id="terminando-a-configuração-do-ssh">Terminando a configuração do SSH</h3>

<p>O SSH vai permitir você acessar arquivos tanto do Linux convidado quanto do Mac
hospedeiro. Para isso, você precisará de uma chave SSH configurada no seu
Mac. Se você não tem, siga <a href="https://git-scm.com/book/en/v2/Git-on-the-Server-Generating-Your-SSH-Public-Key">estas instruções</a>
para gerar uma.</p>

<blockquote>
  <p>Dica:</p>

  <p>Considere usar o <a href="https://github.com/maxgoedjen/secretive">Secretive</a>. Ele é
um app open-source para o Mac que guarda a chave privada SSH no Secure
Enclave, então ninguém (nem mesmo você) tem acesso a ela. Ela é protegida pelo
sua senha de usuário ou Touch ID.</p>

  <p>Mas claro, você consegue ver sua chave pública!</p>
</blockquote>

<p>Copie a chave SSH armazenada em <code class="language-plaintext highlighter-rouge">~/.ssh/id_rsa.pub</code> no seu Mac. De volta à VM,
cole ela no fim do <code class="language-plaintext highlighter-rouge">~/.ssh/authorized_keys</code>. Isso autoriza o seu Mac para
acessar os arquivos da sua máquina virtual Linux através do SSH.</p>

<h2 id="acessando-usando-seu-editor-de-texto">Acessando usando seu editor de texto</h2>

<h3 id="visual-studio-code">Visual Studio Code</h3>

<p>Se você usa o Visual Studio Code, instale a extensão
<a href="https://marketplace.visualstudio.com/items?itemName=ms-vscode-remote.remote-ssh">Remote - SSH</a>.</p>

<p>Depois de instalá-la, você verá na sua esquerda um novo ícone, chamado “Remote
Explorer”. Clique nele, e você verá o <code class="language-plaintext highlighter-rouge">lima-debian</code> como um remote. Passe o seu
mouse por cima, e vai aparecer uma seta. Clique nela, e ele irá se conectar à
sua VM.</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-02-29-lima-development-setup/vscode-lima.png" />
  </figure>
</div>

<p>Agora, você pode usar o VSCode com os arquivos dentro da VM da mesma forma como
você usaria se estivesse trabalhando com ele no hospedeiro.</p>

<h3 id="emacs">Emacs</h3>

<p>Voc~e pode se conectar usando o TRAMP: use o atalho <code class="language-plaintext highlighter-rouge">C-x C-f</code> da mesma forma que
você faria pra abrir um arquivo local, mas use isto como caminho:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>/ssh:localhost#2022:&lt;path&gt;
</code></pre></div></div>

<p>Se você está usando outra porta que não seja a 2022, então substitua
ela. Substitua também <code class="language-plaintext highlighter-rouge">&lt;path&gt;</code> pelo caminho do arquivo na VM que você quer abrir.</p>

<p>Se você adicionou <code class="language-plaintext highlighter-rouge">lima-debian</code> para sua configuração do SSH, então você pode
usar como caminho:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>/ssh:lima-debian:&lt;path&gt;
</code></pre></div></div>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-02-29-lima-development-setup/emacs-lima.png" />
  </figure>
</div>

<h3 id="vim">Vim</h3>

<p>Apenas use o Vim dentro da sua VM :-)</p>

<h3 id="outros-editores--ides">Outros editores / IDEs</h3>

<p>Se você está usando outros editores ou IDEs, você terá que procurar como o
desenvolvimento remoto funciona nele, e configurá-lo para usar o SSH com
<code class="language-plaintext highlighter-rouge">localhost</code> como host e 2022 como porta (ou a porta que você escolheu).</p>

<h2 id="copiando-arquivos">Copiando arquivos</h2>

<p>Agora que você já tem o SSH, você pode usar <code class="language-plaintext highlighter-rouge">scp</code> para mover arquivos do
hospedeiro para o convidado e vice-versa. Ele funciona como o <code class="language-plaintext highlighter-rouge">cp</code> mas ele pode
copiar arquivos entre computadores (neste caso, um físico e uma máquina
virtual).</p>

<p>Do hospedeiro para o convidado:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># troque 2022 pela porta que você escolheu</span>
mac<span class="nv">$ </span><span class="nt">-P</span> 2022 scp my_file localhost:destination

<span class="c"># ou, se você adicionou a instancia ao .ssh/ssh_config:</span>
mac<span class="nv">$ </span>scp my_file lima-debian:destination
</code></pre></div></div>

<p>E do convidado para o hospedeiro:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c"># troque 2022 pela porta que você escolheu</span>
mac<span class="nv">$ </span>scp <span class="nt">-P</span> 2022 localhost:my_file destination

<span class="c"># ou, se você adicionou a instancia ao .ssh/ssh_config:</span>
mac<span class="nv">$ </span>scp lima-debian:my_file destination
</code></pre></div></div>

<h2 id="montando-a-vm-do-lima-no-seu-sistema-de-arquivos">Montando a VM do Lima no seu sistema de arquivos</h2>

<p>Também é possível montar o Lima como um drive através do SSH de forma que você
consegue de forma simples abrir arquivos da VM como se eles estivessem
localizados na sua máquina hospedeira. Isso é possível com o SSHFS.</p>

<p>Mas tenha cuidado! Isso é baseado no MacFUSE, um port do FUSE para Mac. O FUSE é
uma forma interessante de criar sistemas de arquivos falsos no Linux, mas o Mac
não o suporta por padrão. Então, o MacFUSE é um kext (uma extensão de kernel)
que habilita o FUSE no kernel do Mac. Para instalar você precisa desinstalar
algumas proteções no Mac, então, siga com cuidado.</p>

<p>Você pode encontrar mais informação sobre como instalar e configurar o MacFUSE e o SSHFS
<a href="https://osxfuse.github.io">aqui</a>.</p>

<p>Uma vez instalado, crie um diretório vazio em algum lugar no seu sistema de
arquivos do seu Mac (estou usando<code class="language-plaintext highlighter-rouge">~/sshfs/lima</code>). Seguindo a configuração de SSH
que temos até agora, você pode montar a raiz do Lima no seu sistema de arquivos
rodando:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>mac$ sshfs lima-debian:/ &lt;o diretório que você criou&gt;
</code></pre></div></div>

<p>Leva alguns segundos para montar.</p>

<p>Você pode ler mais sobre o <code class="language-plaintext highlighter-rouge">sshfs</code> rodando <code class="language-plaintext highlighter-rouge">sshfs --help</code>. No meu setup, eu
monto a VM do Lima rodando <code class="language-plaintext highlighter-rouge">sshfs lima-debian:/ ~/sshfs/lima</code>. Então, se eu
abro  <code class="language-plaintext highlighter-rouge">~/sshfs/lima</code> eu consigo ver os arquivos da minha VM:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2024-02-29-lima-development-setup/sshfs.png" />
  </figure>
  <figcaption>O Finder mostrando o sistema de arquivos da VM como se fosse um diretório local</figcaption>
</div>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Para aqueles que precisam de um Linux x86-64 em um Mac com Apple Silicon]]></summary></entry><entry xml:lang="pt_br"><title type="html">Git como ferramenta de debug</title><link href="https://lucasoshiro.github.io/posts/2023-02-13-git-debug/" rel="alternate" type="text/html" title="Git como ferramenta de debug" /><published>2023-02-13T00:00:00+00:00</published><updated>2023-02-13T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/git-debug</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2023-02-13-git-debug/"><![CDATA[<h2 id="tem-certeza-fazer-debug-com-git">Tem certeza? Fazer debug com Git</h2>

<p>Quais são as ferramentas que vêm à sua cabeça quando alguém diz “debug”? Deixa
eu tentar adivinhar:</p>

<ul>
  <li>um detector de vazamento de memória (ex: Valgrind);</li>
  <li>um <em>profiler</em> (ex: GNU gprof);</li>
  <li>uma função que para o seu programa e te dá um REPL (ex: a função <code class="language-plaintext highlighter-rouge">breakpoint</code>
do Python ou o <code class="language-plaintext highlighter-rouge">byebug</code> do Ruby);</li>
  <li>alguma coisa que é de fato chamada depurador (ou “debugger”), como o GDB, ou
algum similar que vêm nas IDEs;</li>
  <li>ou ainda a nossa velha amiga, a função <code class="language-plaintext highlighter-rouge">print</code>.</li>
</ul>

<p>Certo, então neste texto eu tentarei te convencer a adicionar o Git a essa lista.</p>

<p>Quando você está versionando algum código com o Git, o repositório é uma
preciosa fonte de informação. Muitas pessoas apenas pensam no Git só como aquele
comando que em que se faz a sequência <code class="language-plaintext highlighter-rouge">git add</code>, <code class="language-plaintext highlighter-rouge">git commit</code> e <code class="language-plaintext highlighter-rouge">git push</code>, da
mesma forma como se faria o upload de um arquivo para o Google Drive ou se
postaria uma foto no Instagram. Porém, como o Git mantém todo o histórico de
<em>commits</em> desde o mais antigo, ele é provavelmente a ferramenta que melhor
conhece o código. Cada versão de cada arquivo é armazenada no repositório (neste
texto estou me referindo por “repositório” o repositório local, não o do GitHub,
GitLab, Bitbucket, etc), e achar informação útil nele é como um trabalho de
arqueologia.</p>

<p>Então, vou então mostrar aqui alguns conceitos e ferramentas úteis para extrair
tudo que você precisa a partir dele!</p>

<h2 id="recapitulando-conceitos-básicos">Recapitulando conceitos básicos</h2>

<p>Antes de seguirmos em frente, vamos primeiro recapitular os conceitos básicos do
Git.</p>

<p><strong>Commits</strong> são as versões de um repositório. Eles são <strong>snapshots</strong>, não
<strong>deltas</strong>, isso significa que um <em>commit</em> não sabe o que foi alterado. Em vez
disso, um <em>commit</em> <strong>guarda o conteúdo de cada arquivo</strong>. Quando você executa
<code class="language-plaintext highlighter-rouge">git show</code>, você não está olhando o conteúdo de um <em>commit</em>, você na verdade
está olhando um <em>patch</em>, ou seja, o que mudou em relação ao <em>commit</em> pai.
Essa mudança, porém, é feita de uma forma inteligente que economiza espaço.</p>

<p><strong>Commits</strong> têm referências a seu(s) <em>commit</em>(s) pais (se houverem):</p>

<ul>
  <li>um <em>commit</em> normal tem um único pai;</li>
  <li>um <em>commit</em> de <em>merge</em> tem dois pais;</li>
  <li>um <em>commit</em> de <em>merge</em> octopus tem dois ou mais pais;</li>
  <li>um <em>commit</em> inicial não tem pai.</li>
</ul>

<p><strong>Commits</strong> também armazenam <strong>quando</strong> e <strong>quem</strong> os criou!</p>

<p><strong>Branches</strong> são só referências para <em>commits</em>. A bem da verdade, uma <em>branch</em> é
só um arquivo que contém o <em>hash</em> de um <em>commit</em>;</p>

<p>O <strong>histórico de commits</strong> não é uma linha do tempo linear! Na verdade, é um
DAG, um grafo acíclico direcionado, em outras palavras, ele é um conjunto de
diferentes linhas do tempo que podem ter um passado em comum (uma bifurcação, ou
    <em>fork point</em> em inglês) e que podem ter estados onde timelines se encontram (um
<em>commit</em> de <em>merge</em>), mas sem nenhum loop!</p>

<p>A <strong>área de staging</strong>, antigamente chamada de <em>cache</em> (nome ainda usado às
vezes…) e internamente chamada de <strong>index</strong> é o lugar onde um <em>commit</em> é
preparado (em outras palavras, é o lugar para onde você manda um arquivo quando
executa <code class="language-plaintext highlighter-rouge">git add</code>). O conteúdo da área de <em>staging</em> é o conteúdo do seu último
commit, além das alterações que você fez usando <code class="language-plaintext highlighter-rouge">git add</code> (aquelas que são
mostradas em verde no <code class="language-plaintext highlighter-rouge">git status</code>).</p>

<p>O <strong>diretório de trabalho</strong> (em inglês, <em>working directory</em>) é o diretório onde
estão armazenados no disco os arquivos do seu projeto. Da perspectiva deu quem
está vendo ou de quem está escrevendo e executando o código, este pode parecer a
principal área do Git (comparado ao histórico de <em>comits</em> e à área de
<em>staging</em>). Porém, da perspectiva do Git, este é a <strong>menos importante</strong>, já que
tudo aqui pode ser modificado, apagado, criado, e o Git não irá registrar, a não
ser, claro, que você explicitamente diga a ele pra fazer isso (usando <code class="language-plaintext highlighter-rouge">git add</code>,
por exemplo).</p>

<p>Se você não conhecia alguma coisa dessa seção, surigro fortemente que leia a 
<a href="https://git-scm.com/book/pt-br/v2/Começando-O-Básico-do-Git">seção 1.3 do livro Pro Git</a>.</p>

<h2 id="pathspec-e-git-ls-files">Pathspec e <code class="language-plaintext highlighter-rouge">git ls-files</code></h2>

<p>Vamos ao nosso primeiro conceito aqui: o <strong>pathspec</strong> (eu enrolo a língua pra
falar essa palavra…). Um <strong>pathspec</strong> é uma string que pode ser passada como
argumento para vários comandos do Git para especificar arquivos.</p>

<p>Uma forma legal de ver os <em>pathspecs</em> funcionando é usando <code class="language-plaintext highlighter-rouge">git ls-files</code>. Esse
comando lista todos os arquivos na área de <em>staging</em>, porém, se você passar um
<em>pathspec</em> como parâmetro, ele irá listar todos os arquivos que casam com esse
<em>pathspec</em>.</p>

<p>O <em>pathspec</em> mais óbvio é o próprio enderço do arquivo. Se você tem um arquivo
chamado <code class="language-plaintext highlighter-rouge">README.md</code>, então <code class="language-plaintext highlighter-rouge">README.md</code> vai ser um pathspec que o representa, e
se ele está dentro de um diretório chamado <code class="language-plaintext highlighter-rouge">src</code>, um <em>pathspec</em> que irá
identificá-lo é <code class="language-plaintext highlighter-rouge">src/README.md</code>. Note que, por padrão, <em>pathspecs</em> são relativos
ao diretório atual</p>

<h3><code class="language-plaintext highlighter-rouge">*</code></h3>

<p>O primeiro superpoder do <em>pathspec</em> que irei mostrar a você é o <code class="language-plaintext highlighter-rouge">*</code>. Esse
caracter casa com zero ou mais caracteres. Por exemplo, este comando lista
<strong>todos os arquivos que terminam em .c na área de staging</strong> e que estão no
<strong>diretório atual</strong> ou em seus <strong>subdiretórios</strong>, recursivamente:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git ls-files <span class="s1">'*.c'</span>
</code></pre></div></div>

<p>Talvez você esteja pensando: “nada novo até agora, é apenas uma expansão de
*”. Bem, na verdade não. Note que <code class="language-plaintext highlighter-rouge">'*.c'</code> está entre aspas, isso significa que
ele não é uma string, e o shell não está expandindo ele. Em vez disso, quem está
fazendo a expansão é o próprio Git.</p>

<p>Mas qual é a diferença? Lembra que eu disse “no diretório atual ou em seus
subdiretórios”? Essa é a diferença entre o <code class="language-plaintext highlighter-rouge">*</code> do <em>pathspec</em> e o do <code class="language-plaintext highlighter-rouge">*</code> do
<em>shell</em>: nessa situação, o <code class="language-plaintext highlighter-rouge">*</code> do shell irá casar apenas com arquivos no
diretório atual, enquanto que o <em>pathspec</em> <code class="language-plaintext highlighter-rouge">*</code> irá casar com todos os arquivos
que estão no diretório atual ou em um subdiretório dele! Dessa forma, se
executarmos:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git ls-files <span class="k">*</span>.c
</code></pre></div></div>

<p>o shell irá substituir <code class="language-plaintext highlighter-rouge">*.c</code> por todos os arquivos que estão no diretório atual,
então o <code class="language-plaintext highlighter-rouge">git ls-files</code> vai listar só eles.</p>

<h3 id="--palavras-mágicas"><code class="language-plaintext highlighter-rouge">:</code> + palavras mágicas</h3>

<p><code class="language-plaintext highlighter-rouge">:</code> é um caracter especial para os <em>pathspecs</em> que é seguido de uma palavra
mágina. Eu não irei entrar em detalhes sobre isso, mas existem dois casos que
acho muito úteis.</p>

<p>O primeiro é o <code class="language-plaintext highlighter-rouge">:/</code>. Ele representa a raiz do repositório. Se você está em um
subdiretório e quer achar arquivos pelos seus caminhos absolutos (isto é,
relativos à raiz do repositório), você terá que usar <code class="language-plaintext highlighter-rouge">:/</code>. Por exemplo, <code class="language-plaintext highlighter-rouge">:/*.c</code>
irá casar com <strong>todos os arquivos que terminam em .c</strong> no repositório, não
importa onde eles estão localizados.</p>

<p>O segundo é <code class="language-plaintext highlighter-rouge">:!</code>. Se a gente colocar <code class="language-plaintext highlighter-rouge">:!</code> na frente de um <em>pathspec</em>, então o
<em>pathspec</em> irá casar com todos os arquivos que não casam com o resto do
<em>pathspec</em>. Por exemplo:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git ls-files <span class="s1">':!*.c'</span>
</code></pre></div></div>

<p>Esse comando irá listar todos os arquivos na área de <em>staging</em> que <strong>não terminam
em .c</strong>.</p>

<h3 id="mais-sobre-pathspecs-e-git-ls-files">Mais sobre pathspecs e git ls-files</h3>

<p><em>Pathspecs</em> são realmente úteis para selecionar arquivos para passar como
argumentos para o Git. Você pode ler mais sobre eles no glossário do Git (<code class="language-plaintext highlighter-rouge">man
gitglossary</code>), procurando por “pathspec”.</p>

<p>O <code class="language-plaintext highlighter-rouge">git ls-files</code>, que eu usei como exemplo para os <em>pathspecs</em>, é uma ótima
ferramenta para encontrar arquivos no repositório. Ele pode substiuir o comando
<code class="language-plaintext highlighter-rouge">find</code>, já que tem uma sintaxe bem mais simples.</p>

<h2 id="git-grep">Git Grep</h2>

<p><code class="language-plaintext highlighter-rouge">git grep</code>, como o próprio nome diz, é um <code class="language-plaintext highlighter-rouge">grep</code> melhorado pelo Git.</p>

<p>E o que isso significa? Bom, lembra que eu disse que o Git é provavelmente a
ferramenta que conhece o seu código? <code class="language-plaintext highlighter-rouge">git grep</code> se aproveita disso para fazer um
<code class="language-plaintext highlighter-rouge">grep</code> melhorado.</p>

<p>A sintaxe do <code class="language-plaintext highlighter-rouge">git grep</code> é, basicamente, a seguinte:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git <span class="nb">grep</span> <span class="o">[</span>&lt;flags&gt;] <span class="o">[</span>&lt;padrão&gt;] <span class="o">[</span>&lt;commit&gt;] <span class="nt">--</span> <span class="o">[</span>&lt;pathspec&gt;]
</code></pre></div></div>

<p>Você pode usar várias <em>flags</em> do <code class="language-plaintext highlighter-rouge">grep</code> no <code class="language-plaintext highlighter-rouge">git grep</code>, como por exemplo, <code class="language-plaintext highlighter-rouge">-E</code>,
<code class="language-plaintext highlighter-rouge">-P</code> ou <code class="language-plaintext highlighter-rouge">-i</code>. O <em>pathspec</em> e o <em>commit</em> são opcionais. O <code class="language-plaintext highlighter-rouge">--</code> é opcional na
maior parte dos casos, porém, é recomendado usá-lo para evitar ambiguidades.</p>

<p>Se você passar umn <em>commit</em>, então o Git Grep vai procurar nele o padrão, mas só
nele, não vai procurar em outros <em>commits</em>.</p>

<p>Se você não fornecer o <em>pathspec</em>, o Git Grep irá procurar pelo padrão em todos
os arquivos no diretório atual ou em seus subdiretórios. Ele é <strong>bem mais
rápido</strong> que o GNU Grep ou o BSD Grep. Você pode ver isso na imagem a seguir,
nela eu estou procurando por <code class="language-plaintext highlighter-rouge">#include</code> no código fonte do próprio Git, usando
BSD Grep, GNU Grep e Git Grep, respectivamente:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/grep-time.png" />
    <figcaption>Git grep vs BSD grep and GNU grep, em um Macbook Air M1</figcaption>
  </figure>
</div>

<p>Mas o que mais o Git Grep pode fazer? Bom, dê uma olhada nas flags
<code class="language-plaintext highlighter-rouge">--heading</code> e <code class="language-plaintext highlighter-rouge">--break</code>. <code class="language-plaintext highlighter-rouge">--heading</code> agrupa a saída pelo arquivo onde está cada
linha, e <code class="language-plaintext highlighter-rouge">--break</code> apenas insere uma linha entre os grupos. Isso é muito útil
para procurar, por exemplo, arquivos que chamam uma função ou usam uma constante.</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/grep-heading.png" />
    <figcaption>Git grep com <code>--heading</code> e <code>--break</code>,
  procurando por <code>looks_like</code> em todos os códigos-fonte C.</figcaption>
  </figure>
</div>

<p>Um recurso bem interessante do Git Grep é a flag <code class="language-plaintext highlighter-rouge">-W</code> (ou
<code class="language-plaintext highlighter-rouge">--show-function</code>). Quando se ela, o Git Grep não só vai mostrar a linha que
contém o que você está procurando, mas vai  também mostrar <strong>toda a função</strong>
onde ela está localizada. Então, vamos olhar o mesmo comando que eu mostrei na
última imagem, porém, adicionando a flag <code class="language-plaintext highlighter-rouge">-W</code>
(<code class="language-plaintext highlighter-rouge">git grep --heading --break -W 'looks_like' -- '*.c'</code>):</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/grep-w.png" />
    <figcaption>Git grep com <code>-W</code> mostrando a função toda que contém <code>looks_like</code>.</figcaption>
  </figure>
</div>

<p>Git Grep é uma ferramenta incrível para encontrar código. Ok, mas você deve
estar pensando “legal, mas eu consigo fazer algo parecido com isso com a
navegação de código da minha IDE, pulando pra definições e para usos”. Isso é
verdade para vários casos. Porém o Git Grep é realmente útil quando você quer
procurar somente em alguns arquivos (usando um <em>pathspec</em> como restrição),
quando você quer procurar por uma <strong>regex</strong> genérica em vez de um nome de uma
variável ou função, quando você quer procurar em <strong>outro commit</strong> ou quando você
só não quer abrir uam IDE e prefere procurar <strong>a partir do terminal</strong>. Não é uma
ferramenta que substitui outras, e sim uma ferramenta complementa as outras.</p>

<h2 id="git-blame">Git Blame</h2>

<p>Se você já usou alguma vez o <code class="language-plaintext highlighter-rouge">git blame</code>, é bem provável que vocẽ esteja
esperando que eu fale sobre ele e como ele é maravilhoso. Se esse é o caso,
então por favor, não pule esta seção porque eu tenho algo realmente importante
para te dizer.</p>

<p>Se esse não é o caso e você nunca ouviu falar ou nunca usou o <code class="language-plaintext highlighter-rouge">git blame</code>, ele é
uma ferramenta que mostra, para cada linha, quem foi <strong>a última pessoa</strong> que a
<strong>mudou</strong>, qual foi o <strong>commit</strong> em que essa alteração foi feita, e a <strong>data e
hora</strong> dessa mudança. Olhe para a imagem a seguir. Eu estou rodando 
<code class="language-plaintext highlighter-rouge">git blame Main.hs</code>, em que <code class="language-plaintext highlighter-rouge">Main.hs</code> é um arquivo que eu escrevi:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/git-blame.png" />
    <figcaption>Git blame. A primeira coluna mostra os primeiros caracteres do
  <i>hash</i> do último <i>commit</i> que alterou aquela linha, Main.hs é o nome do
  arquivo, Lucas Oshiro (também conhecido como eu) é a última pessoa que alterou
  essas linhas. Você também pode ver a data e a hora dessa última mudança.
      </figcaption>
  </figure>
</div>

<p>Legal, então, isso me mostra evidências para que eu possa xingar o código de
alguém que trabalha comigo? Bom, na maior parte das vezes, sim, mas lembre-se: o
<code class="language-plaintext highlighter-rouge">git blame</code> mostra apenas quem fez a <strong>última modificação</strong>. Talvez essa pessoa
apenas mudou o nome de uma variável, aplicou uma mudança no estilo do código,
moveu uma declaração de uma função para outro arquivo, ou qualquer outra mudança
que seja na pratica seja quase irrelevante para o funcionamento do
código. Muitas vezes a pessoa nem sabe o que o código faz (por exemplo, talvez a
pessoa apenas executou uma ferramenta que formata código, sem nem ter lido ele).</p>

<p>Isso também se aplica à outra informação: <strong>a data e a hora</strong> que é mostrado é
apenas a última vez que a linha foi <strong>alterada</strong>, e não nos diz quando ela foi
<strong>criada</strong>. A mesma coisa vale para o <strong>commit</strong>: o <em>commit</em> que é mostrado é o
útilmo <em>commit</em> que alterou alguma coisa na linha, não aquele que alterou alguma
coisa <strong>útil</strong> ou o <em>commit</em> que primeiro adicionou aquela linha.</p>

<p>O Git Blame (e outras ferramentas baseadas nele, como o Annotate nas IDEs da
JetBrains, o <code class="language-plaintext highlighter-rouge">magit-blame</code> no Emacs, ou o GitLens no VSCode) é sem dúvida
bastante útil, porém, não é uma fonte da verdade. Se você quer saber algo além
de apenas o que ocorreu na última mudança na linha, então você precisará de algo
mais poderoso…</p>

<h2 id="git-log-e-seus-poderes-secretos">Git Log e seus poderes secretos</h2>

<p><code class="language-plaintext highlighter-rouge">git log</code> é um dos mais famosos comandos do Git. Ele é comando que você executa
para ver o <strong>histórico de commits</strong>. Nada novo até aqui. Porém, ele tem alguns
recursos menos conhecidos que eu considero como sendo o próximo passo para
quando o Git Blame não é o suficiente para suas necessidades.</p>

<h3 id="passando-um-pathspec-como-argumento-para-o-git-log">Passando um <em>pathspec</em> como argumento para o Git Log</h3>

<p>Você pode <strong>restringir</strong> a saída do <code class="language-plaintext highlighter-rouge">git log</code> passando um <em>pathspec</em> como seu
último argumento, assim: <code class="language-plaintext highlighter-rouge">git log -- &lt;pathspec&gt;</code>. De novo, o <code class="language-plaintext highlighter-rouge">--</code> pode ser
omitido na maior parte dos casos, porém, é uma boa prática mantê-lo para evitar
ambiguidades.</p>

<p>Quando você faz isso, a saída irá conter apenas os <em>commits</em> que <strong>introduziram
uma mudança</strong> nos arquivos que casam com o <em>pathspec</em>, em relação a seus
<em>commits</em> anteriores. Olhe esse exemplo:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/git-log-path.png" />
    <figcaption>Histórico de <i>commits</i>.</figcaption>
  </figure>
</div>

<p>Se você quer saber quando alguma coisa foi introduzida, você pode inspecionar
esses <em>commits</em>. Quando você encontrar em qual <em>commit</em> foi feita essa
alteração, você irá descobrir <strong>quem</strong> e <strong>quando</strong> introduziu o <em>commit</em>. Se a
mensagem de <em>commit</em> foi bem escrita e se a mudança foi atômica, você ainda
saberá <strong>porque</strong> o commit foi criado (e porque o código existe). Se você está
usando GitHub, você também poderá copiar o <em>hash</em> desse <em>commit</em> e procurar o
Pull Request que o contém, e isso é ainda mais informação, já que você pode ler
a discussão e a revisão de código!</p>

<p>Esse recurso do Git Log salvou minha vida várias vezes. Se eu encontrava um
trecho de código que era difícil de entender para que servia, em vez de tentar
lê-lo, eu usava o Git Log para encontrar o <em>commit</em> que o introduziu e entender
o que a pessoa que o escreveu estava tentando fazer, qual o contexto dessa
introdução, qual o problema que ela queria resolver, e assim por diante. Apenas
tente fazer isso!</p>

<h3 id="a-flag--p">A flag <code class="language-plaintext highlighter-rouge">-p</code></h3>

<p>Apesar de tudo, pode ser bem entendiante olhar cada <em>commit</em> manualmente. Você
pode usar <code class="language-plaintext highlighter-rouge">-p</code> para mostrar o <em>patch</em> de cada <em>commit</em>. Em outras palavras, é
como executar <code class="language-plaintext highlighter-rouge">git show</code> para cada <em>commit</em> que aparece no log:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/git-log-p.png" />
    <figcaption>O mesmo que a última imagem, porém usando a flag <code>-p</code></figcaption>
  </figure>
</div>

<h3 id="a-flag--l">A flag <code class="language-plaintext highlighter-rouge">-L</code></h3>

<p>Talvez o arquivo seja muito longo e você só quer checkar o log de uma pequena
porção dele. Então você pode usar a flag <code class="language-plaintext highlighter-rouge">-L</code> para restringir para a parte do
código que te interessa. Ela tem duas variantes:</p>

<ol>
  <li>
    <p>Você pode restringir pelos limites de um intervalo, que pode ser números de
linhas ou expressão expressões regulares: <code class="language-plaintext highlighter-rouge">git log -L &lt;start&gt;,&lt;end&gt;:&lt;file&gt;</code>.
Por exemplo: <code class="language-plaintext highlighter-rouge">git log -L 10,20:my_file.c</code> vai mostrar o log para o intervalo
entre as linhas 10 e 20 do my_file.c;</p>
  </li>
  <li>
    <p>(Eu acho esse ainda mais legal) Você pode ver o log de uma função:
<code class="language-plaintext highlighter-rouge">git log -L :&lt;function&gt;:&lt;file&gt;</code></p>
  </li>
</ol>

<p>Neste exemplo, estou vendo o log da função <code class="language-plaintext highlighter-rouge">M412</code> do arquivo <code class="language-plaintext highlighter-rouge">M412.cpp</code> do 
<a href="https://github.com/MarlinFirmware/Marlin">Marlin</a> usando
<code class="language-plaintext highlighter-rouge">git log -L :M412:M412.cpp</code>:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/git-log-l.png" />
    <figcaption><code>git log -L</code> em ação. Note que estou usando
    <a href="https://github.com/dandavison/delta">delta</a> para formatar a saída
    </figcaption>
  </figure>
</div>

<h3 id="a-flag--s">A flag <code class="language-plaintext highlighter-rouge">-S</code></h3>

<p>A flag <code class="language-plaintext highlighter-rouge">-S</code> é um tesouro perdido no Git Log. Com ele, você pode ver todos os
<em>commits</em> que aumentaram ou diminuíram o número de ocorrências de uma
string. Pessoalmente falando, ele praticamente aposenta o Git Blame para mim:
mesmo se uma pessoa moveu um trecho de código para outro lugar ou para outro
arquivo, o <code class="language-plaintext highlighter-rouge">git log -S</code> vai conseguir encontrar a introdução dele.</p>

<p>Na imagem a seguir, eu estou usando <code class="language-plaintext highlighter-rouge">git log -S</code> para encontrar a primeira
introdução de uma string contida no arquivo <code class="language-plaintext highlighter-rouge">hardcoded_values.c</code> (como você pode
ver na saída do primeiro <code class="language-plaintext highlighter-rouge">git grep</code>). Depois, note que essa string não foi
originalmente introduzida nesse arquivo (como você pode ver na saída do segudo
<code class="language-plaintext highlighter-rouge">git grep</code>). A princípio, ele era parte do arquivo <code class="language-plaintext highlighter-rouge">state_machine.c</code>, então ele
foi movido para outro arquivo. Isso resolve o problema do Git Blame apenas
“culpar” a pessoa que moveu aquela linha, em vez da que a criou.</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/git-log-s.png" />
    <figcaption>Perdão, Git Blame...</figcaption>
  </figure>
</div>

<p>Você ainda pode usar <code class="language-plaintext highlighter-rouge">-G</code> em vez de <code class="language-plaintext highlighter-rouge">-S</code>. Isso permite usar uma expresão
regular em vez de uma string.</p>

<h2 id="git-bisect">Git Bisect</h2>

<p>O <code class="language-plaintext highlighter-rouge">git blame</code> nos diz a última mudança de uma linha e o <code class="language-plaintext highlighter-rouge">git log -S</code> nos diz
quando uma string foi introduzida ou removida. Porém, eles só operam sobre
texto. Para vários casos isso é suficiente, porém, às vezes você não quer
procurar por mudanças em um texto, mas quer procurar por mudanças no
comportamento do programa, como novos <em>bugs</em> ou qualquer outra coisa que não
esteja funcionando como esperado.</p>

<p>Nesses casos, o <code class="language-plaintext highlighter-rouge">git blame</code> ou o <code class="language-plaintext highlighter-rouge">git log -S</code> não serão suficientes, porque
você não sabe qual código causou essa mudança de comportamento, e você não sabe
exatamente o que procurar. Em projetos complexos, talvez essa mudança foi feita
em um lugar que você nunca imaginaria, como por exemplo, em uma classe ou função
que você pensou que não fosse relacionada à que quebrou.</p>

<p>E como o Git pode nos ajudar a encontrar essa mudança?</p>

<p>Senhoras e senhores, é uma honrar apresentar a vocês o meu comando favorito do
Git: o <strong>Git Bisect</strong>! Ele nos permite <strong>encontrar o commit que quebrou
alguma coisa</strong> no código. Dado um <em>commit</em> “bom” (um <em>commit</em> que não está
quebrado, criado antes da introdução do <em>bug</em>), e um <em>commit</em> “ruim” (um
<em>commit</em> em que o código certamente está quebrado), o Git irá fazer uma <strong>busca
binária</strong> até que o <em>commit</em> quebrado seja encontrado.</p>

<p>Uma vez encontrado esse <em>commit</em>, você pode olhá-lo e conseguir todo o tipo de
informação que discutimos anteriormente.</p>

<p>O Git Bisect pode ser usado de duas maneiras: uma mais <strong>manual</strong>, em que ele
guia você até que o <em>commit</em> que introduziu o <em>bug</em> seja encontrado, e uma
<strong>automática</strong>, que o Git encontra esse <em>commit</em> pra você.</p>

<h3 id="um-exercício-prático">Um exercício prático</h3>

<p>Eu vou demonstrar o Git Bisect usando este repositório:
<a href="https://github.com/lucasoshiro/bisect_demo">https://github.com/lucasoshiro/bisect_demo</a>.
Ele é bem simples, apenas contém um único arquivo Python, com um código bem
estranho e difícil de entender:</p>

<div class="language-python highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="c1">#!/usr/bin/env python3
</span>
<span class="kn">from</span> <span class="nn">sys</span> <span class="kn">import</span> <span class="n">argv</span>
<span class="kn">from</span> <span class="nn">math</span> <span class="kn">import</span> <span class="n">log</span>

<span class="n">ops</span> <span class="o">=</span> <span class="mh">0x2B2D2F2C2A5E3E5F</span>

<span class="k">def</span> <span class="nf">func</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">):</span>
    <span class="k">return</span> <span class="s">'</span><span class="se">\n</span><span class="s">'</span><span class="p">.</span><span class="n">join</span><span class="p">(</span>
        <span class="p">(</span><span class="k">lambda</span> <span class="n">r</span><span class="p">:</span> <span class="sa">f</span><span class="s">'</span><span class="si">{</span><span class="n">a</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">f</span><span class="si">}</span><span class="s"> </span><span class="si">{</span><span class="n">b</span><span class="si">}</span><span class="s"> = </span><span class="si">{</span><span class="n">r</span><span class="si">}</span><span class="s">'</span><span class="p">)(</span><span class="nb">eval</span><span class="p">(</span><span class="sa">f</span><span class="s">'</span><span class="si">{</span><span class="n">a</span><span class="si">}{</span><span class="n">f</span><span class="si">}{</span><span class="n">b</span><span class="si">}</span><span class="s">'</span><span class="p">))</span>
        <span class="k">for</span> <span class="n">f</span> <span class="ow">in</span> <span class="n">ops</span><span class="p">.</span><span class="n">to_bytes</span><span class="p">((</span><span class="nb">int</span><span class="p">(</span><span class="n">log</span><span class="p">(</span><span class="n">ops</span><span class="p">,</span> <span class="mi">16</span><span class="p">))</span> <span class="o">+</span> <span class="mi">1</span><span class="p">)</span> <span class="o">//</span> <span class="mi">2</span><span class="p">,</span> <span class="s">'big'</span><span class="p">).</span><span class="n">decode</span><span class="p">())</span>


<span class="k">if</span> <span class="n">__name__</span> <span class="o">==</span> <span class="s">'__main__'</span><span class="p">:</span>
    <span class="n">a</span><span class="p">,</span> <span class="n">b</span> <span class="o">=</span> <span class="nb">map</span><span class="p">(</span><span class="nb">int</span><span class="p">,</span> <span class="n">argv</span><span class="p">[</span><span class="mi">1</span><span class="p">:])</span>
    <span class="k">print</span><span class="p">(</span><span class="n">func</span><span class="p">(</span><span class="n">a</span><span class="p">,</span> <span class="n">b</span><span class="p">))</span>
</code></pre></div></div>

<p>E o que ele faz? Bom, ele recebe dois números como argumentos, e realiza algumas
operações usando eles:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/calc-py.png" />
    <figcaption><code>calc.py</code> executando.</figcaption>
  </figure>
</div>

<p>Ele funciona para a maior parte dos números, exceto se o segundo é 0. Como uma
das operações é a divisão e como nós não estamos tratando erros de divisão
por zero nesse código, esta entrada quebra o script:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/div-zero.png" />
    <figcaption>Ah não...</figcaption>
  </figure>
</div>

<p>Como você pode ver, nós sabemos onde o código está quebrando, porém, não
conseguimos ver nenhuma operação de divisão nele. Se quisermos corrigir esse
código, primeiro precisamos saber o que causou essa divisão, e isso não está
claro aqui.</p>

<p>Claro que podemos executar <code class="language-plaintext highlighter-rouge">git log</code> aqui e tentar achar um <em>commit</em> que possa
ter inserido esse <em>bug</em>. Porém, mesmo executando <code class="language-plaintext highlighter-rouge">git log -p -- calc.py</code> não
será de grande ajuda. Veja:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/bisect-log.png" />
    <figcaption>Nada útil aqui. A mensagem de <code>commit</code> diz nada sobre o código
  (só nome de frutas...) e a única mudança entre um <code>commit</code> e outro é um valor
  hexadecimal.
  </figcaption>
  </figure>
</div>

<p>Hora do Git Bisect nos salvar!</p>

<h3 id="rodando-o-git-bisect-manualmente">Rodando o Git Bisect manualmente</h3>

<p>A primeira coisa que você precisa fazer é iniciar a bisseção (a busca binária,
ou em inglês <em>bisect</em>), usando o comando <code class="language-plaintext highlighter-rouge">git bisect start</code>. Se você executar <code class="language-plaintext highlighter-rouge">git
status</code>, ele mostrará que a bisseção foi iniciada. Alguns <em>shells</em> que mostram
informações sobre o Git no <em>prompt</em> também mostram a bisseção foi iniciada. Se
você já fez o que precisava com a bisseção, então você deve executar <code class="language-plaintext highlighter-rouge">git bisect
reset</code> para terminá-la.</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/bisect-status.png" />
    <figcaption>Iniciando a bisseção</figcaption>
  </figure>
</div>

<p>Eu disse que para fazermos a bisseção, precisamos de um “<em>commit</em> ruim” e um
“<em>commit</em> bom”. Neste caso, nós sabemos que o último <em>commit</em>  é ruim, já que
ele quebra quando passamos 0 como segundo parâmetro.</p>

<p>Em um cenário real, provavelmente você saberá qual é um “bom” <em>commit</em>, ele será
qualquer commit que contém um código que funciona, por exemplo, o <em>commit</em> da
última <em>release</em> que não esteja quebrada. No caso deste exemplo, eu digo a você
que o primeiro <em>commit</em> não tem bugs. Se você quiser ver isso, faça um
<em>checkout</em> para ele e tente executar <code class="language-plaintext highlighter-rouge">calc.py</code> passando 0 como segundo argumento:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/initial-commit.png" />
    <figcaption>Não faz nada, porém, pelo menos não está dividindo por zero.</figcaption>
  </figure>
</div>

<p>Dessa forma, agora sabemos um <em>commit</em>  bom e um ruim, e nossa situação é esta
(os <em>commits</em> estão em ordem cronológica, o primeiro <em>commit</em> é o primeiro):</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>8959689 Início     &lt;- BOM!
f1a445e banana
e516236 goiaba
0acc414 Laranja
18c911e Toranja
0f3d5c7 Limão
7e27a60 Framboesa
f16e5e7 Morango
c3eb7db Carambola  &lt;- RUIM!
</code></pre></div></div>

<p>E agora precisamos dizer ao Git Bisect sobre isso. Executamos
<code class="language-plaintext highlighter-rouge">git bisect good 8959689</code> para dizer que o <em>commit</em> inicial é bom. Como o
<em>commit</em> atual é ruim, então podemos executar apenas <code class="language-plaintext highlighter-rouge">git bisect bad</code> para dizer
ao Git Bisect isso, mas você poderia também executar <code class="language-plaintext highlighter-rouge">git bisect bad c3eb7db</code>, ou
passar como argumento qualquer outro <em>commit</em> que você saiba que é ruim.</p>

<p>Depois de executar isso, o Git Bisect vai automaticamente fazer um <em>checkout</em>
para o <em>commit</em> que está no meio do histório entre o bom e o ruim, ou seja, o
<em>commit</em> <code class="language-plaintext highlighter-rouge">18c911e</code> (<code class="language-plaintext highlighter-rouge">Toranja</code>). Após isso, executamos
<code class="language-plaintext highlighter-rouge">./calc.py &lt;algum número&gt; 0</code> para decidir se esse <em>commit</em> é bom ou ruim.</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/bisect-first.png" />
    <figcaption>E descobrimos que esse <i>commit</i> é um dos ruins...</figcaption>
  </figure>
</div>

<p>Certo, então nossa situação é a seguinte:</p>

<div class="language-plaintext highlighter-rouge"><div class="highlight"><pre class="highlight"><code>8959689 Início     &lt;- BOM!
f1a445e banana
e516236 goiaba
0acc414 Laranja
18c911e Toranja    &lt;- RUIM!
0f3d5c7 Limão
7e27a60 Framboesa
f16e5e7 Morango
c3eb7db Carambola  &lt;- RUIM!
</code></pre></div></div>

<p>E, novamente, precisamos dizer ao Git Bisect que esse <em>commit</em> é um dos
ruins. Então, executamos <code class="language-plaintext highlighter-rouge">git bisect bad</code>. Como você deve imaginar, agora o Git
Bisect vai fazer um <em>checkout</em> para o <em>commit</em> que está no meio dos <em>commits</em> 
<code class="language-plaintext highlighter-rouge">8959689</code> (<code class="language-plaintext highlighter-rouge">Início</code>) and <code class="language-plaintext highlighter-rouge">18c911e</code> (<code class="language-plaintext highlighter-rouge">Toranja</code>). Esse <em>commit</em> é o
<code class="language-plaintext highlighter-rouge">e516236</code> (<code class="language-plaintext highlighter-rouge">goiaba</code>).</p>

<p>Agora fazemos a mesma coisa de antes: executamos <code class="language-plaintext highlighter-rouge">./calc.py &lt;something&gt; 0</code>,
vemos se ele quebra ou não, se sim então executamos <code class="language-plaintext highlighter-rouge">git bisect bad</code>, caso
contrário executamos <code class="language-plaintext highlighter-rouge">git bisect good</code>, até que a busca binária termine e
encontre o <em>commit</em> com problemas. Fazemos isso aqui:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/bisect-result.png" />
    <figcaption>Executando <code> git bisect bad</code> e <code>git bisect
  good</code> até que a busca binária chegue ao fim.</figcaption>
  </figure>
</div>

<p>Finalmente encontramos o <em>commit</em> que introduziu o bug: <code class="language-plaintext highlighter-rouge">0acc414</code>
(<code class="language-plaintext highlighter-rouge">Laranja</code>). Agora você pode sair da bisseção com <code class="language-plaintext highlighter-rouge">git bisect reset</code>, e o Git
irá voltar para o mesmo <em>commit</em> que você estava quando executou <code class="language-plaintext highlighter-rouge">git bisect
start</code>. Se você está com curiosidade para saber porque essa mudança quebra o
código, aqui está uma dica: 0x2F é o valor ASCII do caracter <code class="language-plaintext highlighter-rouge">/</code> em hexadecimal.</p>

<p>O Git Bisect é legal, porém, executá-lo manualmente dessa forma (verificando se
um <em>commit</em> é bom ou ruim e em seguida executando <code class="language-plaintext highlighter-rouge">git bisect bad</code> ou <code class="language-plaintext highlighter-rouge">git
bisect good</code>) pode ser bem entendiante. Dependendo da situação, é possível fazer
isso de forma automática usando <code class="language-plaintext highlighter-rouge">git bisect run</code>!</p>

<h3 id="rodando-o-git-bisect-automaticamente">Rodando o Git Bisect automaticamente</h3>

<p>Caso exista um <strong>comando que diga se um <em>commit</em> é bom ou ruim</strong>, então o Git
Bisect pode fazer a busca binária automaticamente! Esse comando pode ser
qualquer coisa, como um <em>shellscript</em>, um <em>script</em> Python, um executável, um
teste, entre várias outras coisas. O único requisito é que seu <em>status code</em>
deve seguir algumas regras:</p>

<ul>
  <li>Se o <em>commit</em> é bom, então o comando deverá devolver 0;</li>
  <li>Se o <em>commit</em> é ruim, então o comando deverá devolver qualquer coisa entre 1 e
127, inclusivamente, exceto 125;</li>
  <li>Se não é possível decidir se um <em>commit</em> é ruim ou bom, então ele precisa ser
ignorado, e para isso o deverá devolver 125.</li>
</ul>

<p>Neste exemplo, estamos verificando se o código lança uma exceção. Por padrão,
quando um código termina sua execução em um exceção em Python, então seu <em>status
code</em> é 1, ou é 0 quando a execução termina sem problemas. Então, apenas
executar <code class="language-plaintext highlighter-rouge">./calc.py &lt;algum número&gt; 0</code> é suficiente, já que ele irá devolver 0
quando tudo terminou sem problemas e 1 quando um <em>bug</em> ocorreu. Porém, lembre-se
de que esse não é sempre o caso, e dependendo é possível que você precise
escrever um script de teste para tomar essa decisão.</p>

<p>Nós começamos a bisseção da mesma forma que antes:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code>git bisect start
git bisect good &lt;<span class="nb">hash </span><span class="k">do </span>commit bom&gt;
git bisect bad
</code></pre></div></div>

<p>Como queremos fazer a bisseção automática usando como critério <code class="language-plaintext highlighter-rouge">./calc.py 14 0</code>,
então executamos <code class="language-plaintext highlighter-rouge">git bisect run ./calc.py 14 0</code>. Funciona como mágica:</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/bisect-run.png" />
    <figcaption>Sim, isso mesmo: é um comando que encontra o <i>bug</i> para você!</figcaption>
  </figure>
</div>

<p>Depois disso, você também precisa executar <code class="language-plaintext highlighter-rouge">git bisect reset</code> para terminar a
bisseção. E é isso. Não é legal?</p>

<h2 id="conclusão">Conclusão</h2>

<p>Esses comandos me ajudaram muito quando eu navegava em bases de código bem
grandes e preciava encontrar as causas <em>bugs</em>. Mas não apenas isso, eles podem
ajudar a entender o código, por eles serem, essencialmente, ferramentas de
busca. Simples e flexíveis, mas incrivelmente poderosas.</p>

<p>Obrigado pela leitura, se você encontrou algo errado ou tem alguma sugestão,
abra uma issue no <a href="https://github.com/lucasoshiro/lucasoshiro.github.io/issues">meu GitHub</a>.</p>

<h2 id="2024-update">2024 update</h2>

<p>Isto chegou em 5 no Hacker News!</p>

<div class="img-container">
  <figure>
    <img class="small" src="/assets/images/posts/2023-02-13-git-debug/hn.png" />
    <figcaption>#5 no HN!!!</figcaption>
  </figure>
</div>

<p>Depois de receber alguns feedbacks, eu atualizei este post com 
<code class="language-plaintext highlighter-rouge">git log -L:funcname:file</code>, que eu não conhecia antes
<a href="https://news.ycombinator.com/item?id=40952074">desta resposta</a>!</p>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Debug com Git Grep, Git Blame, Git Log e Git Bisect]]></summary></entry><entry xml:lang="pt_br"><title type="html">Git: merge com submódulos</title><link href="https://lucasoshiro.github.io/posts/2022-03-12-merge-submodule/" rel="alternate" type="text/html" title="Git: merge com submódulos" /><published>2022-03-12T00:00:00+00:00</published><updated>2022-03-12T00:00:00+00:00</updated><id>https://lucasoshiro.github.io/posts/merge-submodule</id><content type="html" xml:base="https://lucasoshiro.github.io/posts/2022-03-12-merge-submodule/"><![CDATA[<p>Se você lida com um projeto versionado com o Git e que usa submódulos, talvez
você já tenha passado por uma situação em que precisou alterar um submódulo em
uma <em>branch</em>, e precisou fazer o <em>merge</em> dessa <em>branch</em> em outra.</p>

<p>Por exemplo, supondo que a estrutura do seu projeto seja esta a seguir, com dois
arquivos Python (sendo um dentro de um subdiretório) e um diretório contendo uma
biblioteca. Neste exemplo, essa biblioteca <strong>não</strong> é um diretório “copiado” para
dentro do projeto, e sim um projeto separado mas que é incluído aqui através de
um submódulo:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span>tree 

├── algum_arquivo.py
├── algum_diretorio
│   └── outro_arquivo.py
└── biblioteca_que_fica_em_submodulo
│   └── arquivo_da_biblioteca.py
└── .gitmodules
</code></pre></div></div>

<p>Como essa biblioteca é incluída via submódulo, sua versão ficará <strong>fixada</strong> em
um <em>commit</em> até que alguém explicitamente a mude. Isso pode ser feito, por
exemplo, da seguinte forma:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span>git <span class="nt">-C</span> biblioteca_que_fica_em_submodulo fetch
<span class="nv">$ </span>git <span class="nt">-C</span> biblioteca_que_fica_em_submodulo checkout &lt;commit da versão nova&gt;
<span class="nv">$ </span>git add biblioteca_que_fica_em_submodulo
<span class="nv">$ </span>git commit
</code></pre></div></div>

<p>Caso você tenha feito isso em uma <em>branch</em> sua e queira que essa alteração entre
em outra <em>branch</em>, provavelmente você fará um <em>merge</em>.  Supondo que essa outra
<em>branch</em> seja a <code class="language-plaintext highlighter-rouge">main</code> e a sua seja chamada <code class="language-plaintext highlighter-rouge">pr-branch</code>:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span>git checkout main
<span class="nv">$ </span>git merge pr-branch
</code></pre></div></div>

<p>O grafo de <em>commits</em> ficaria assim, com as setas pontilhadas apontando para as
versões dos submódulos:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/merge_duvida.svg" />
    <figcaption>Grafo de <i>commits</i></figcaption>
  </figure>
</div>

<p>Como a imagem mostra, queremos saber <strong>para qual <em>commit</em></strong> do submódulo o
<em>commit</em> de <em>merge</em> vai apontar.</p>

<p>Caso a <code class="language-plaintext highlighter-rouge">main</code> <strong>não</strong> tenha tido nenhuma alteração no submódulo enquanto você
desenvolvia a <code class="language-plaintext highlighter-rouge">pr-branch</code>, o <em>merge</em> ocorre do jeito esperado e a
biblioteca fica na versão nova. Caso contrário, o comportamento não é tão
trivial:</p>

<ul>
  <li>pode ser que a versão que esteja na <code class="language-plaintext highlighter-rouge">main</code> permaneça;</li>
  <li>pode ser que a que esteja na <code class="language-plaintext highlighter-rouge">pr-branch</code> permaneça;</li>
  <li>pode ser que aconteça um conflito que o Git não consiga resolver
automaticamente sem intervenção de alguém.</li>
</ul>

<p>A partir desse ponto, não encontrei algum material que explicasse de forma
completa qual é o comportamento do Git nesses casos. Para entender o que
acontece, precisei ir mais a fundo no Git, inclusive lendo o código fonte, e
então resolvi escrever este post :-).</p>

<h2 id="breve-explicação-sobre-objetos">Breve explicação sobre objetos</h2>

<p>Caso você já tenha familiaridade com o funcionamento dos objetos no Git, pode
pular para a próxima seção. Aqui não é meu objetivo explicar a fundo como eles
funcionam, só o que precisamos para entender o <em>merge</em> e os submódulos.</p>

<p>Então, caso você não tenha familiaridade com o funcionamento interno do Git,
sugiro fortemente as seções 1.3 “What is Git?”, 10.2 “Git Objects” e 10.3 “Git
References” do livro Pro Git, disponível gratuitamente em vários formatos em
<a href="https://git-scm.com/book/en/v2">https://git-scm.com/book/en/v2</a>.</p>

<p>Um tl;dr rápido com o que precisamos: os dados de um repositório (por
“repositório” entenda o repositório <strong>local</strong> em cada máquina) é armazenado em
unidades chamadas <strong>objetos</strong>. Esta é uma representação gráfica bem básica de
como os objetos se relacionam entre si:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/objetos.svg" />
    <figcaption>Objetos <i>blob</i>, <i>commit</i> e <i>tree</i>, e <i>branch</i></figcaption>
  </figure>
</div>

<p>Um tipo de objeto é o nosso velho conhecido <em>commit</em>. Cada <em>commit</em> guarda o
estado de todo o projeto no momento em que foi feito (e não apenas as
alterações). Esse estado é chamado de <em>snapshot</em>, e pode ser entendido como uma
“fotografia” do projeto naquele momento.</p>

<p>Outros tipos de objetos são <em>tree</em> e <em>blob</em>. Uma <em>tree</em> representa o estado de
um diretório, sendo uma listagem de seus conteúdos: outros diretórios filhos
(cada um com seu conteúdo representado por uma <em>tree</em>), ou arquivos (cada um com
seu conteúdo representado por um <em>blob</em>).</p>

<p>Cada <em>commit</em> aponta para a <em>tree</em> que representa a raiz do projeto no estado
que o <em>commit</em> guarda.</p>

<p>Cada <em>commit</em> aponta para seu(s) <em>commit(s)</em> pai(s), se houver:</p>
<ul>
  <li>Um <em>commit</em> inicial não tem pai;</li>
  <li>Um <em>commit</em> comum tem apenas um pai;</li>
  <li>Um <em>commit</em> de <em>merge</em> tem dois ou mais pais, apontando para quais <em>commits</em>
foram mesclados para que este <em>commit</em> fosse criado. Normalmente fazemos
<em>merge</em> de apenas uma <em>branch</em> em outra, logo, o <em>commit</em> resultante
normalmente tem dois pais.</li>
</ul>

<p>Todo objeto é identificado por seu <em>hash</em> SHA-1. Objetos são <strong>únicos</strong> e
<strong>imutáveis</strong>. Isso significa, por exemplo, que:</p>
<ul>
  <li>dois arquivos iguais são representados pelo mesmo <em>blob</em>;</li>
  <li>dois diretórios iguais são representados pela mesma <em>tree</em>;</li>
  <li>um arquivo que tem o mesmo conteúdo em <em>commits</em> distintos é
representado pelo mesmo <em>blob</em> em ambos;</li>
  <li>um arquivo que tem conteúdos diferentes em <em>commits</em> distintos é representado
por <em>blobs</em> diferentes uns dos outros em cada um dos <em>commits</em>.</li>
</ul>

<p>Uma <em>branch</em> não é um objeto. Ela é apenas uma referência, um ponteiro para um
<em>commit</em>. Internamente, ela é simplesmente um arquivo com o <em>hash</em> de um
<em>commit</em> dentro.</p>

<h2 id="breve-explicação-sobre-merge">Breve explicação sobre <em>merge</em></h2>

<h3 id="fast-forward"><em>Fast-forward</em></h3>

<p>Ainda no mesmo exemplo, quando fizemos <code class="language-plaintext highlighter-rouge">git merge pr-branch</code>, podemos ter
uma situação que a <code class="language-plaintext highlighter-rouge">pr-branch</code> aponta para um <em>commit</em> <strong>descendente</strong> do
<em>commit</em> que <code class="language-plaintext highlighter-rouge">main</code> aponta. Nesse caso, por padrão o Git não faz um <em>merge</em>
verdadeiro, e sim um <em>fast-forward</em>. Isso significa que o Git simplesmente vai
alterar a <code class="language-plaintext highlighter-rouge">main</code> para que aponte para o mesmo <em>commit</em> que a
<code class="language-plaintext highlighter-rouge">pr-branch</code>.</p>

<p>Ilustrando como isso acontece, a situação antes do <em>fast-forward</em> era esta, com
o grafo azul representando os <em>commits</em> do projeto, e o vermelho representando os
<em>commits</em> do submódulo:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/ff-antes.svg" />
    <figcaption>Grafo de <i>commits</i> antes do <i>fast-forward</i></figcaption>
  </figure>
</div>

<p>Depois do <em>fast-forward</em>:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/ff-depois.svg" />
    <figcaption>Grafo de <i>commits</i> do <i>fast-forward</i></figcaption>
  </figure>
</div>

<p>Esse caso dispensa mais explicações quanto ao ponto principal do post, já que,
obviamente, a biblioteca estará na mesma versão que a <code class="language-plaintext highlighter-rouge">pr_branch</code> após o
<em>fast-forward</em>, já que a <code class="language-plaintext highlighter-rouge">main</code> passa a apontar para o mesmo <em>commit</em> que
<code class="language-plaintext highlighter-rouge">pr-branch</code>.</p>

<h3 id="merge-verdadeiro"><em>Merge</em> verdadeiro</h3>

<p>Um <em>merge</em> verdadeiro ocorre caso o <em>commit</em> que <code class="language-plaintext highlighter-rouge">pr_branch</code> aponta não
seja descendente do <em>commit</em> que <code class="language-plaintext highlighter-rouge">main</code> aponta, sendo então criado o <em>commit</em>
com dois pais que mencionei anteriormente. Esse comportamento também pode ser
forçado mesmo quando é possível um <em>fast-forward</em>, usando a <em>flag</em> <code class="language-plaintext highlighter-rouge">--no-ff</code>.</p>

<p>O <code class="language-plaintext highlighter-rouge">git merge</code> pode ter comportamentos distintos de acordo com a estratégia
escolhida. Por padrão nas versões mais novas do Git a estratégia usada é a
<code class="language-plaintext highlighter-rouge">ort</code>. Em versões um pouco mais antigas, a estretégia padrão é a <code class="language-plaintext highlighter-rouge">recursive</code>.</p>

<p>Este post irá abordar a partir daqui, o comportamento da <code class="language-plaintext highlighter-rouge">ort</code>. Porém, o que for
abordado também vale para a <code class="language-plaintext highlighter-rouge">recursive</code>, mas não para as outras.</p>

<h3 id="three-way-merge"><em>Three-way merge</em></h3>

<p>A decisão sobre o que deve ser escolhido para entrar no <em>commit</em> de merge é
feita por um algoritmo chamado <em>three-way merge</em>. Esse algoritmo se baseia em
três <em>commits</em>: os dois <em>commits</em> apontados pelas <em>branches</em> que queremos fazer
o <em>merge</em>, e o melhor ancestral comum desses dois <em>commits</em>.</p>

<p>Por “melhor ancestral comum” entre dois <em>commits</em>, entenda: um ancestral comum
de dois <em>commits</em> X é melhor que outro ancestral comum Y se X for descendente de
Y. O “melhor de todos” é o que será usado. Mais informações na 
<a href="https://git-scm.com/docs/git-merge-base">manpage do git merge-base</a>.</p>

<p>Nos três exemplos a seguir, o “melhor ancestral comum” das <em>branches</em> A e B é o
<em>commit</em> amarelo:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/merge_base.svg" />
    <figcaption>Melhores ancestrais comuns</figcaption>
  </figure>
</div>

<p>Vamos denotar por A e B os dois <em>commits</em> apontados pelas <em>branches</em> que
queremos fazer o <em>merge</em>, e por O o melhor ancestral comum a eles dois. Um
arquivo poderá, então, ter até três versões diferentes, uma em A, uma em B e
outra em O.</p>

<p>Para tomar a decisão de qual será usada, o <em>three-way merge</em> faz a seguinte regra:</p>
<ul>
  <li>Se o arquivo tem o mesmo conteúdo em A e em B, no <em>commit</em> de merge ele terá esse conteúdo;</li>
  <li>Caso contrário:
    <ul>
      <li>Se o arquivo tem o mesmo conteúdo em A e em O, no <em>commit</em> de merge ele terá
o conteúdo de B;</li>
      <li>Se o arquivo tem o mesmo conteúdo em B e em O, no <em>commit</em> de merge ele terá
o conteúdo de A;</li>
    </ul>
  </li>
  <li>Caso contrário (o arquivo tem conteúdos distintos entre si em A, B e O): <strong>conflito</strong>.</li>
</ul>

<p>Podemos ver isso na imagem a seguir. As bolinhas representam conteúdos
diferentes do mesmo arquivo ao longo dos <em>commits</em>.</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/3-way-merge.svg" />
    <figcaption><i> Three-way merge</i></figcaption>
  </figure>
</div>

<p>A comparação entre os estados não é feita usando o arquivo inteiro: o Git
compara o <em>hash</em> dos <em>blobs</em> em cada um dos estados, o que é suficiente pra
dizer se eles são iguais ou não (lembrando: caso o arquivo seja igual em
<em>commits</em> diferentes, ele é representado pelo mesmo <em>blob</em>).</p>

<p>Caso haja um conflito e o arquivo for um arquivo de texto puro, o Git por padrão
ainda faz o <em>three-way merge</em> internamente no conteúdo. Dessa forma, por
exemplo, se a mudança de O para A seja em um local distinto de O pra B dentro do
arquivo, ambas são preservadas. Caso elas tenham sido feitas no mesmo local, o
Git adiciona as marcas de conflito para que sejam resolvidas pelo usuário
(aquelas <code class="language-plaintext highlighter-rouge">&lt;&lt;&lt;&lt;&lt;&lt;&lt;</code>, <code class="language-plaintext highlighter-rouge">=======</code> e <code class="language-plaintext highlighter-rouge">&gt;&gt;&gt;&gt;&gt;&gt;&gt;</code>).</p>

<p>Arquivos binários não são resolvidos, o usuário deverá escolher qual versão que
deverá ser usada no <em>commit</em> de merge.</p>

<h2 id="breve-explicação-sobre-submódulos">Breve explicação sobre submódulos</h2>

<p>Bom, se você chegou até aqui, provavelmente não precisa de uma introdução aos
submódulos. Mas ainda assim, vale a pena mostrar como eles são representados
internamente.</p>

<p>Vimos que cada <em>tree</em> representa o conteúdo de um diretório. Com o comando
<code class="language-plaintext highlighter-rouge">git ls-tree</code> podemos ver o conteúdo de uma <em>tree</em> . Se fizermos
<code class="language-plaintext highlighter-rouge">git ls-tree HEAD</code> podemos verificar o conteúdo da <code class="language-plaintext highlighter-rouge">tree</code> do <em>commit</em> atual.
No nosso exemplo, seria algo parecido com isso:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span>git ls-tree HEAD
100644 blob 123abc456def123abc456def123abc456def9999 .gitmodules
100644 blob 1a2b3c4d5e6f1a2b3c4d5e6f1a2b3c4d5e6f1234 algum_arquivo.py
040000 tree aaaaabbbbbcccccdddddeeeeefffff1111122222 algum_diretorio
160000 commit fedcba0123456789fedcba012345678912345678 biblioteca_que_fica_em_submodulo
</code></pre></div></div>

<p>Os <em>hashes</em> nas linhas do <code class="language-plaintext highlighter-rouge">algum_arquivo.py</code> e do <code class="language-plaintext highlighter-rouge">.gitmodules</code> indicam os
<em>blobs</em> que armazenam seus respectivos conteúdos, e da mesma forma, o <em>hash</em> na
linha de <code class="language-plaintext highlighter-rouge">algum_diretorio</code> indica a <em>tree</em> que armazena o conteúdo desse
diretório.</p>

<p>Porém, na linha da <code class="language-plaintext highlighter-rouge">biblioteca_que_fica_em_submodulo</code>, o <em>hash</em> que aparece é
justamente o <em>hash</em> do <em>commit</em> do submódulo referente à versão atual da
biblioteca. Caso seja feita uma alteração da versão dessa biblioteca, esse <em>hash</em>
muda, consequentemente a <em>tree</em> que representa o diretório raiz do projeto será
outro objeto, ou seja, será outro <em>snapshot</em>.</p>

<p>Ilustrando isso, os submódulos ficam assim:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/objetos_submodulo.svg" />
    <figcaption>Submódulos dentro do grafo dos objetos</figcaption>
  </figure>
</div>

<p>Além disso, ainda temos o arquivo <code class="language-plaintext highlighter-rouge">.gitmodules</code>, que armazena propriedades dos
submódulos, como, por exemplo, seu diretório (<code class="language-plaintext highlighter-rouge">path</code>) e a URL do repositório de
onde ele é clonado (<code class="language-plaintext highlighter-rouge">url</code>). Mais informações sobre o <code class="language-plaintext highlighter-rouge">.gitmodules</code> estão na sua
<a href="https://git-scm.com/docs/gitmodules">manpage</a>.</p>

<h2 id="three-way-merge-de-submódulos"><em>Three-way merge</em> de submódulos</h2>

<p>O <em>three-way merge</em> ainda valerá se fizermos o <em>merge</em> de <em>commits</em> que tenham
submódulos. E o mecanismo é o mesmo que serviria para fazer o <em>three-way merge</em>
de arquivos, porém, em vez de comparar <em>hashes</em> de <em>blobs</em>, comparamos <em>hashes</em>
de <em>commits</em> do submódulo:</p>

<ul>
  <li>Se o submódulo aponta para o mesmo <em>commit</em> em A e B, esse <em>commit</em> será usado
no <em>commit</em> de merge;</li>
  <li>Caso contrário:
    <ul>
      <li>Se o submódulo aponta para o mesmo <em>commit</em> em A e em O, o <em>commit</em> para que
ele aponta em B será usado no <em>commit</em> de merge;</li>
      <li>Se o submódulo aponta para o mesmo <em>commit</em> em B e em O, o <em>commit</em> para que
ele aponta em A será usado no <em>commit</em> de merge;</li>
    </ul>
  </li>
  <li>Caso contrário (o submódulo aponta para <em>commits</em> distintos em A, B e O): <strong>conflito</strong>.</li>
</ul>

<p>Tudo tranquilo até aqui, mas o que acontece quando temos um conflito…</p>

<h2 id="resolução-de-conflitos-de-submódulos">Resolução de conflitos de submódulos</h2>

<p>Caso haja um conflito entre submódulos, dependendo da situação o Git tenta
resolver automaticamente: caso o <em>commit</em> do submódulo em A seja descendente do
<em>commit</em> do submódulo em B, o <em>commit</em> do submódulo em A será usado. O contrário
também vale: caso o <em>commit</em> do submódulo em B seja descendente do <em>commit</em> do
submódulo em A, o <em>commit</em> do submódulo em B será usado. Esse comportamento você
pode ver
<a href="https://github.com/git/git/blob/c2162907e9aa884bdb70208389cb99b181620d51/merge-ort.c#L1653-L1669">aqui, no código-fonte do Git</a>.
Em outras palavras, é feito um <em>fast-forward</em> no submódulo.</p>

<p>Graficamente, a situação antes era esta:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/ff-submodulo-antes.svg" />
    <figcaption><i> Fast-forward </i> de submódulos antes do merge</figcaption>
  </figure>
</div>

<p>Depois do <em>merge</em> com <em>fast-forward</em> de submódulo, a situação é esta:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/ff-submodulo-depois.svg" />
    <figcaption><i> Fast-forward </i> de submódulos depois do merge</figcaption>
  </figure>
</div>

<p>Caso não seja possível esse <em>fast-forward</em>, o Git indica <strong>conflito</strong> e o
usuário deverá resolver manualmente, como nesta situação:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/conflito_submodulo_antes.svg" />
    <figcaption>Conflito de submódulos</figcaption>
  </figure>
</div>

<p>Ainda assim, caso esses <em>commits</em> não sejam descendentes um do outro <strong>mas</strong>
exista algum <em>commit</em> de <em>merge</em> que seja descendente de ambos, esse <em>commit</em>
será <strong>sugerido</strong> para o usuário como uma possível solução para usar como <em>commit</em>
do submódulo no <em>merge</em>, e cabe ao usuário aceitá-la ou não. Esse comportamento pode ser visto
<a href="https://github.com/git/git/blob/c2162907e9aa884bdb70208389cb99b181620d51/merge-ort.c#L1671-L1714">aqui, no código-fonte do Git</a>.</p>

<p>Vale ressaltar também que essas formas de resolução de conflitos só são
possíveis caso estejam presentes localmente os objetos referentes aos <em>commits</em>
do submódulo. Caso eles não estejam presentes (por exemplo, por um <code class="language-plaintext highlighter-rouge">git clone</code>
sem <code class="language-plaintext highlighter-rouge">--recursive</code>, ou por falta de um <code class="language-plaintext highlighter-rouge">git submodule update</code>), o Git não será
capaz de resolver e irá indicar <strong>conflito</strong>.</p>

<h2 id="e-o-github-e-o-gitlab">E o GitHub e o GitLab?</h2>

<p>A <code class="language-plaintext highlighter-rouge">libgit2</code> é uma biblioteca em C que provê as funcionalidades do Git.
Segundo o <a href="https://github.com/libgit2/libgit2/blob/9c9405df21051791d0a9092d6f363dfce3fe4544/README.md">README</a> da <code class="language-plaintext highlighter-rouge">libgit2</code>,
tanto o GitHub e o GitLab trabalham usando a <code class="language-plaintext highlighter-rouge">libgit2</code>. A
<code class="language-plaintext highlighter-rouge">libgit2</code> não tenta resolver conflitos de submódulos, como pode ser visto
<a href="https://github.com/libgit2/libgit2/blob/2a0d0bd19b5d13e2ab7f3780e094404828cbb9a7/src/libgit2/merge.c#L862-L866">aqui, no código-fonte da libgit2</a>,
e isso também vale para o GitHub e o GitLab.</p>

<p>Para ver isso na prática:</p>
<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span>git checkout main
<span class="nv">$ </span>git submodule update <span class="nt">--init</span>
<span class="nv">$ </span>git branch pr-branch

<span class="c"># Adicionando um commit à main</span>
<span class="nv">$ </span>git <span class="nt">-C</span> biblioteca_que_fica_em_submodulo checkout algum_commit~ <span class="c"># esse ~ é proposital</span>
<span class="nv">$ </span>git add biblioteca_que_fica_em_submodulo
<span class="nv">$ </span>git commit

<span class="c"># Adicionando um commit à pr-branch</span>
<span class="nv">$ </span>git checkout pr-branch
<span class="nv">$ </span>git submodule update <span class="nt">--init</span>
<span class="nv">$ </span>git <span class="nt">-C</span> biblioteca_que_fica_em_submodulo checkout algum_commit <span class="c"># descendente do commit na main</span>
<span class="nv">$ </span>git add biblioteca_que_fica_em_submodulo
<span class="nv">$ </span>git commit

<span class="c"># Git push, para fazermos um PR/MR logo em seguida</span>
<span class="nv">$ </span>git push origin pr-branch <span class="c"># supondo que seu remote se chame origin</span>
</code></pre></div></div>

<p>Chegamos a uma situação parecida com esta:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/merge-github-antes.svg" />
    <figcaption><i>Branches</i> apontando para <i>commits</i> de submódulos em que pode ser feito um <i>fast-forward</i></figcaption>
  </figure>
</div>

<p>Localmente, nesse caso um <code class="language-plaintext highlighter-rouge">git checkout main &amp;&amp; git merge pr-branch</code> funciona,
porque o Git fará um <em>fast-forward</em> do submódulo. Mas se você abrir um Pull
Request (GitHub) ou Merge Request (GitLab) para a <em>branch</em> <code class="language-plaintext highlighter-rouge">pr-branch</code>, vai ser
indicado um conflito no submódulo.</p>

<h3 id="como-resolver">Como resolver?</h3>

<p>Caso você esteja nessa situação, pode fazer isto:</p>

<div class="language-bash highlighter-rouge"><div class="highlight"><pre class="highlight"><code><span class="nv">$ </span>git fetch origin main <span class="c"># supondo que seu remote se chame "origin"</span>
<span class="nv">$ </span>git checkout pr-branch
<span class="nv">$ </span>git submodule update <span class="nt">--init</span>
<span class="nv">$ </span>git merge origin/main
<span class="nv">$ </span>git push origin pr-branch <span class="c"># supondo que seu remote se chame "origin"</span>
</code></pre></div></div>

<p>O que deixará o grafo de <em>commits</em> nesta situação:</p>

<div class="img-container">
  <figure>
    <img class="large" src="/assets/images/posts/2022-03-12-merge-submodule/merge-github-ff.svg" />
    <figcaption><i>Merge</i> de <code>main</code> na <code>pr-branch</code></figcaption>
  </figure>
</div>

<p>O PR/MR não estará mais com conflito. E por que funciona? Bom, fizemos um
<em>merge</em> da <code class="language-plaintext highlighter-rouge">main</code> na <code class="language-plaintext highlighter-rouge">pr-branch</code>, o que localmente é bem-sucedido já que o Git
foi capaz de fazer um <em>fast-forward</em> do submódulo.</p>

<p>Quando fizermos o <code class="language-plaintext highlighter-rouge">push</code>:</p>
<ol>
  <li>Se ninguém alterar a <code class="language-plaintext highlighter-rouge">main</code> nesse meio-tempo, <code class="language-plaintext highlighter-rouge">pr-branch</code> será descendente da
<code class="language-plaintext highlighter-rouge">main</code>, o que permite um <em>fast-forward</em>;</li>
  <li>Caso alguém tenha alterado a <code class="language-plaintext highlighter-rouge">main</code> nesse meio-tempo, a <code class="language-plaintext highlighter-rouge">main</code> antiga (que
você fez o <code class="language-plaintext highlighter-rouge">fetch</code>) será a melhor ancestral comum entre a <code class="language-plaintext highlighter-rouge">main</code> nova (com a
alteração da outra pessoa) e <code class="language-plaintext highlighter-rouge">pr-branch</code>. Dessa forma, caso a <code class="language-plaintext highlighter-rouge">main</code> nova não
tenha alterado o submódulo em relação à <code class="language-plaintext highlighter-rouge">main</code> antiga, o submódulo da
<code class="language-plaintext highlighter-rouge">pr-branch</code> será escolhido no <em>three-way merge</em>. Isso também valerá caso você
opte por não usar um <em>fast-forward</em> no GitHub/GitLab.</li>
</ol>

<h2 id="conclusão">Conclusão</h2>

<p>Quando fazemos <code class="language-plaintext highlighter-rouge">git merge pr-branch</code>, o Git tenta mesclar os submódulos usando
<em>three-way merge</em>. Se não for possível, tenta um <em>fast-forward</em> para o <em>commit</em>
descendente do submódulo, se houver. GitHub e GitLab não fazem esse
<em>fast-forward</em>, então, precisamos fazer o <em>merge</em> localmente, resolvendo o
conflito do submódulo manualmente ou automaticamente, de forma que permita o
que o GitHub ou GitLab façam o <em>three-way merge</em> sem cair no caso de conflito.</p>]]></content><author><name>Lucas Seiki Oshiro</name></author><summary type="html"><![CDATA[Post explicando como o git-merge lida com submódulos]]></summary></entry></feed>